Un backtest de trading par LLM exige un audit des dates de l’information, en plus d’un audit des données de prix. Limiter le prompt à des observations historiques n’établit ni ce que le modèle a appris pendant son entraînement, ni ce que ses outils peuvent récupérer. Sans cette distinction, une simulation rentable peut être prise pour la preuve d’une prévision que le système aurait réellement pu faire à l’époque.
Cette note de méthodologie prend TradingAgents comme étude de cas. La question porte sur la validité du test, pas sur le nombre d’agents ni sur la longueur de leur débat. Un résultat crédible exige une version de modèle documentée, des données point-in-time, une exécution réaliste et des preuves qui résistent à une évaluation réellement vierge.
Mis à jour le 1er novembre 2026 : cette révision remplace l’affirmation initiale, générale, d’une contamination avérée par une distinction entre risque de fuite et fuite démontrée. Elle ancre la discussion de TradingAgents sur la version v7 d’arXiv et précise ce qu’un backtest court permet d’établir. Nous ne le traderions pas tel quel : c’est de la recherche uniquement. Ceci n’est pas un conseil en investissement.
Qu’établit le résultat de TradingAgents ?
L’étude TradingAgents rapporte une simulation historique, pas la preuve que son système complet était disponible et tradait de façon prospective sur cette période. La vraie question est de savoir si le système évalué n’avait accès qu’à l’information disponible avant chaque décision. Une liste de données datées aide à y répondre, mais ne la tranche pas pour chaque composant.
TradingAgents v7, datée du 3 juin 2025, fixe sa simulation du 1er janvier au 29 mars 2024. Elle utilise des données de prix, d’actualité, de sentiment et de fondamentaux. Sa discussion des modèles de base cite GPT-4o, GPT-4o-mini et o1-preview. Les auteurs indiquent restreindre les données à chaque jour de trading et attribuent la brièveté de la fenêtre au coût des modèles et des outils.
Ces déclarations ne vérifient pas de manière indépendante la provenance temporelle de chaque modèle, de chaque document récupéré et de chaque transformation. Cette revue ne reproduit pas les rendements publiés et ne démontre pas que le framework a utilisé des faits futurs. La critique défendable est qu’une affirmation de déploiement exige des preuves plus solides qu’une courte simulation rétrospective et qu’une déclaration selon laquelle les données étaient historiques.
Par où l’information future peut-elle entrer ?
L’information future peut entrer par l’entraînement du modèle, les documents récupérés, les choix de recherche ou les hypothèses d’exécution. Ce sont des chemins d’audit distincts, et en corriger un ne ferme pas les autres. Une évaluation utile consigne le moment où chaque information est devenue disponible, le moment où le système pouvait y accéder et la façon dont elle a influencé une décision simulée.
| Chemin d’audit | Défaillance possible | Preuves à conserver |
|---|---|---|
| Paramètres du modèle | L’entraînement ou une adaptation ultérieure inclut des résultats postérieurs à la date de décision | Checkpoint exact, provenance de l’entraînement et contrôles temporels |
| Recherche documentaire et variables | Un rapport révisé ou un article ultérieur est récupéré sous une date d’événement antérieure | Date de publication d’origine, millésime des données et réponses complètes des outils |
| Sélection en recherche | Les prompts ou les stratégies sont choisis après examen des résultats d’évaluation | Historique des expériences, choix figés et période de validation vierge |
| Exécution | Un signal calculé sur la clôture obtient une exécution avant d’avoir pu être transmis | Horodatage de la décision, moment de l’ordre, prix exécutable et coûts |
La période couverte par un rapport financier n’est pas sa date de publication. Une série macroéconomique téléchargée aujourd’hui peut contenir des révisions indisponibles au moment de la décision simulée. La même discipline temporelle s’applique aux embeddings, aux étiquettes de sentiment, aux résumés et aux modèles auxiliaires qui préparent les données d’un agent.
Une consigne générique demandant d’agir comme si l’on était à une date antérieure n’est pas un mécanisme documenté pour retirer des paramètres du modèle les connaissances ultérieures. La recherche filtrée par date exige aussi des résultats archivés : la date d’événement d’une page peut différer de la date à laquelle son contenu actuel est devenu disponible.
Des données historiques excluent-elles une fuite par le modèle ?
Des données historiques n’excluent pas, à elles seules, l’information retenue dans les paramètres d’un modèle. En revanche, la date de sortie plus tardive d’un modèle ne prouve pas qu’il a mémorisé un résultat ni qu’il l’a utilisé dans une décision donnée. Traitez la contamination possible comme une menace testable pour la validité, et distinguez cette menace d’un effet mesuré.
Une date de sortie, une date limite de pré-entraînement annoncée et la date de la dernière mise à jour par apprentissage sont des faits différents. Un fine-tuning ou un autre entraînement ultérieur peut compter même si le pré-entraînement s’est arrêté plus tôt. À l’inverse, une version sortie plus tard peut reposer sur un corpus d’entraînement plus ancien. Consignez le checkpoint réel et les éléments disponibles sur son historique, plutôt que de tout déduire du nom du produit.
L’effet empirique dépend aussi de la tâche. Glasserman et Lin (2023) ont comparé des titres d’actualité originaux et anonymisés dans une étude de trading fondée sur le sentiment. Les titres anonymisés ont mieux performé dans la fenêtre d’entraînement du modèle, ce qui suggère que la connaissance des entreprises pouvait distraire autant qu’aider dans ce cadre. Ce résultat n’innocente ni ne condamne TradingAgents ; il montre pourquoi l’effet doit être étudié plutôt que présumé.
Parmi les diagnostics utiles figurent la suppression des identifiants d’entreprise quand la tâche le permet, la comparaison de millésimes de modèles et le test d’observations réellement postérieures. Aucun ne constitue un certificat universel : l’anonymisation peut modifier la tâche, et un changement de performance d’une période à l’autre peut aussi refléter un régime de marché différent. Rapportez les contrôles et leurs limites.
Que peuvent vous apprendre trois mois ?
Un backtest de trois mois peut révéler des erreurs d’implémentation, décrire les rendements réalisés et mesurer le drawdown dans cet échantillon. Il n’apporte que des preuves limitées sur la performance dans d’autres régimes ou face à des pertes rares. Une fenêtre courte reste un backtest ; le problème est d’en tirer une affirmation de robustesse que l’échantillon observé ne peut pas soutenir.
Le drawdown maximal observé sur un échantillon calme n’est pas une borne du drawdown futur. Annualiser un échantillon court ne crée pas d’observations supplémentaires. De même, de nombreuses observations journalières corrélées ou des décisions répétées sur des actifs liés ne fournissent pas automatiquement de nombreux tests indépendants de la stratégie.
Un test plus long peut améliorer la couverture, mais il ne peut pas réparer une fuite d’information. Davantage de dates historiques traitées par le même dispositif contaminé restent des dates contaminées. Établissez d’abord la frontière de l’information, puis évaluez la longueur de l’échantillon, la dépendance, l’incertitude et la sensibilité aux périodes retenues.
Qu’exigerait une évaluation crédible ?
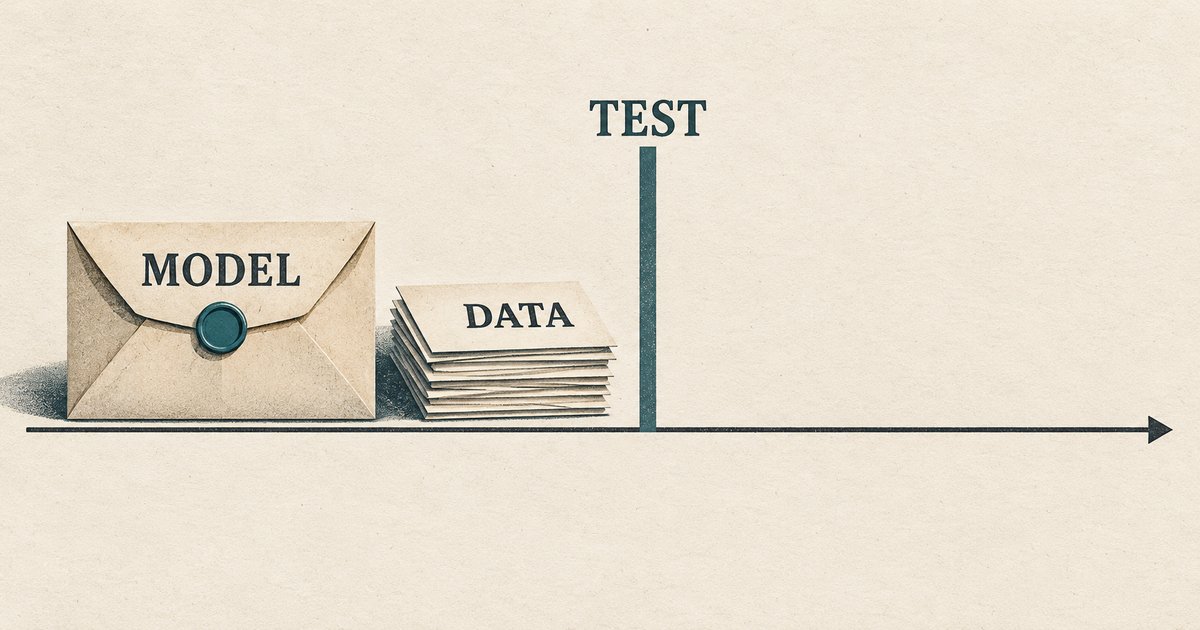
Une évaluation crédible fige le système avant les observations qui servent à le juger, conserve des preuves point-in-time et rapporte les coûts d’exécution et de sélection. Le test prospectif offre un moyen direct d’établir la chronologie. Une reconstruction historique peut aussi être instructive lorsque le modèle et chaque étape d’apprentissage ou de recherche documentaire ont une frontière temporelle défendable.
- Définir l’affirmation. Distinguez un diagnostic historique, une comparaison d’architectures et l’affirmation qu’une stratégie aurait pu être déployée à une date donnée.
- Figer le système évalué. Consignez les checkpoints du modèle ou les versions d’API épinglées, les prompts, les outils, le code, les paramètres d’échantillonnage et toutes les modifications ultérieures. Un simple alias d’API ne suffit pas comme provenance.
- Auditer chaque source d’information. Conservez les dates de publication, les millésimes d’origine, les sorties de la recherche documentaire et la provenance des transformations de variables apprises. Vérifiez le post-entraînement autant que le pré-entraînement.
- Séparer le développement de l’évaluation. Consignez les prompts et les variantes de stratégie essayés. Réservez une période vierge après la sélection, et lancez une nouvelle évaluation dès que la règle de décision change.
- Rendre l’exécution simulée possible. Utilisez des prix disponibles après la décision et le délai de transmission. Tenez compte des spreads, des frais, du slippage, de la rotation et, le cas échéant, des contraintes d’emprunt de titres. Rapportez séparément les coûts d’inférence et d’outils.
- Rapporter la variabilité et les échecs. Montrez la sensibilité entre exécutions répétées quand les sorties sont stochastiques, les références pertinentes, les écarts d’exposition et les périodes d’échec. Précisez ce que couvrent, et ne couvrent pas, les intervalles de confiance ou les hypothèses de rééchantillonnage.
- Tenir un registre prospectif. Horodatez et conservez les décisions avant que les résultats n’arrivent. Le paper trading teste la chronologie sans engager de capital, même si son modèle d’exécution doit encore être examiné.
Les modèles à restriction temporelle sont une piste de recherche concrète. He et ses collègues (2025) décrivent ChronoBERT et ChronoGPT, entraînés sur les textes disponibles à des dates successives. Leurs résultats, propres à certaines tâches, sont une raison de tester des contrôles temporels, pas une affirmation universelle selon laquelle tout backtest par LLM serait valide ou invalide.
Peut-on encore backtester des stratégies générées par un LLM ?
Un LLM qui aide à écrire le code d’une stratégie déterministe pose un problème d’évaluation différent de celui d’un LLM qui prend chaque décision de trading historique. Le code obtenu peut être inspecté et testé avec des contrôles temporels ordinaires. Le chercheur doit malgré tout tenir compte d’une sélection de stratégie guidée par des résultats connus et réserver des observations qui n’ont pas orienté le développement.
Inspectez les indicateurs générés à la recherche de références à des lignes futures, d’une normalisation sur l’échantillon complet et d’exécutions à un prix connu seulement après la décision. Figez la règle avant d’évaluer la période de validation. Réécrire une règle à répétition jusqu’à ce que sa période de validation s’améliore transforme cette période en données de développement, que le code ait été écrit par une personne ou par un LLM.
L’extraction de texte, l’assistance à la recherche et l’automatisation opérationnelle peuvent être utiles sans prétendre à un alpha de trading. Si une variable textuelle apprise entre dans une stratégie historique, la provenance de son modèle relève toujours de l’audit. Un logiciel utile et la preuve de rendements hors échantillon sont deux affirmations distinctes.
Qu’est-ce qui changerait cette évaluation ?
Une évaluation prospective documentée, ou un test historique reproductible doté de contrôles temporels crédibles, apporterait des preuves plus solides que la critique examinée ici. L’amélioration décisive est une chaîne auditable allant de la disponibilité de l’information à la décision et à l’exécution. Les transcriptions de débats et les explications plausibles peuvent aider à examiner le comportement, mais ne suffisent pas à établir cette chaîne.
La version initiale de cet article qualifiait l’évaluation historique des LLM d’impossible par principe et tenait la connaissance du futur pour établie. Ces affirmations étaient trop larges. La position révisée est plus étroite : une provenance temporelle non vérifiée affaiblit une affirmation de prévision, et un échantillon court ne peut pas établir une performance robuste d’un régime à l’autre.
La conclusion reste sceptique quant aux affirmations de déploiement. Nous ne le traderions pas tel quel : c’est de la recherche uniquement. Ce jugement porte sur les preuves examinées ici ; il n’accuse personne de faute et ne démontre pas que les calculs publiés par les auteurs sont faux.
Sources et périmètre
Cette revue sépare ce qu’affirme un article de recherche des preuves nécessaires pour valider une affirmation de déploiement. Les travaux cités fournissent l’étude de cas et le contexte méthodologique ; aucune expérience n’a été reproduite pour cet article. Les liens versionnés permettent d’identifier les références même si les articles ou leurs logiciels associés changent par la suite.
- TradingAgents, v7, 3 juin 2025 : sections 4.3, 5.1, 5.2 et la note de bas de page de la section 6.1.2. La première version arXiv contient des dates contradictoires entre la description des données et celle de la simulation ; la discussion ci-dessus s’appuie sur la v7.
- Glasserman et Lin, 2023 : une étude, propre à une tâche, du biais d’anticipation et de l’effet de distraction dans l’analyse de sentiment fondée sur GPT.
- He et ses collègues, 2025 : des modèles de langage chronologiquement cohérents et leur évaluation.
- Kong et ses collègues, 2026 : un article de position plaidant pour une prise en compte explicite des biais d’évaluation des LLM financiers.
KreamEdge n’a aucun lien avec les auteurs, les projets ou les fournisseurs de modèles cités, et aucun d’eux ne cautionne ce contenu. Il s’agit d’un contenu pédagogique de méthodologie, pas d’un conseil financier ni d’une recommandation d’acheter, de vendre ou de suivre une stratégie. Les performances passées ne préjugent pas des résultats futurs.
Questions fréquentes (FAQ)
Peut-on backtester un agent de trading LLM ?
Oui, mais le test historique d’un agent LLM exige des preuves sur la provenance du modèle, les données point-in-time, la recherche documentaire, la sélection de la stratégie et la chronologie de l’exécution. Une simulation peut être utile tout en restant une preuve insuffisante d’une capacité de prévision déployable. Le test prospectif d’un système figé fournit un registre plus clair des informations qui ont précédé chaque décision.
La sortie ultérieure d’un modèle prouve-t-elle une contamination ?
Non. Une date de sortie n’établit pas le contenu des données d’entraînement et ne montre pas qu’une décision donnée a utilisé un résultat futur. Un modèle plus récent peut soulever une sérieuse question de validité temporelle, mais mesurer ou écarter ce risque exige la provenance du checkpoint, des contrôles appropriés et, de préférence, une évaluation réellement prospective.
Un prompt historique empêche-t-il le biais d’anticipation ?
Non. Restreindre le prompt visible ne traite qu’un seul chemin d’information. Les paramètres du modèle, les documents récupérés, les données révisées et les prétraitements appris peuvent encore contenir des informations postérieures à la date de décision. Des consignes demandant d’ignorer la connaissance du futur ne remplacent pas des contrôles temporels.
Un backtest de trois mois est-il dénué de sens ?
Non. Il peut révéler des bugs et décrire la performance et le drawdown au sein de cet échantillon. Sa durée limitée affaiblit les affirmations portant sur d’autres régimes et sur les pertes rares. Allonger la durée n’aide la couverture qu’une fois traitées la fuite d’information, les effets de sélection et les hypothèses d’exécution.
Une date limite de pré-entraînement suffit-elle ?
Non. Un fine-tuning ultérieur, d’autres étapes d’apprentissage, l’accès aux outils et des sources de données mises à jour influent aussi sur l’information disponible pour un système. Auditez le checkpoint évalué et la chaîne complète. Une date limite de pré-entraînement antérieure ne certifie pas, à elle seule, un test historique non contaminé.
Recherches KreamEdge associées
Ces notes de méthodologie examinent des aspects complémentaires de la validité d’un backtest : sélection de modèle, taille d’échantillon, données historiques, dimensionnement des positions et diffusion des événements. Elles étendent l’audit au-delà du modèle de langage lui-même. Chacune traite une question distincte, si bien que les vérifications pertinentes dépendent de ce qu’affirme la stratégie ou l’infrastructure.
- Dimensionnement des positions : un résultat nul (en anglais)
- Pourquoi screener et stratégie relèvent d’une même boucle d’optimisation (en anglais)
- Combien de trades par paramètre un backtest exige (en anglais)
- Déflateur de liquidité SPX : un biais silencieux des backtests longs (en anglais)
- SSE en production : construire un flux de signaux fiable (en anglais)
- Filtre de régime de marché : un résultat nul (en anglais)
- La gestion du risque après la déroute de l’IA : volatilité et biais (en anglais)
- Comment choisir la taille des barres : 1D ou 1H (en anglais)
0 commentaire