La plupart des chaînes systématiques coupent le travail en deux. D’abord, un screener classe les titres et applique des filtres d’entrée. Ensuite, une couche de trading distincte choisit les stops, les règles de détention et les sorties. Chaque brique est réglée sur son propre objectif, puis on les assemble. Le portefeuille final est censé hériter de la qualité des deux moitiés.
Ce découpage arrange les responsables techniques et les monorepos. Il correspond mal à la façon dont le risque de portefeuille se forme réellement. La sélectivité, le moment de sortie, la rotation, l’exposition et le drawdown évoluent ensemble. Un candidat qui paraît pointu comme modèle de classement peut paraître faible une fois que les stops et les limites de détention entrent en jeu. Une politique de stop qui paraît propre sur un flux de signaux figé peut se révéler brutale sur un ensemble d’entrées plus lâche.
KreamEdge n’entraîne pas d’abord un screener pour confier ensuite ses choix à une stratégie optimisée séparément. Il évalue un candidat de bout en bout. Ce candidat peut modifier en un seul essai la formule de score, les filtres d’entrée, les règles d’achat et de vente, les stops et les sorties de détention. La fitness n’est attribuée qu’une fois que ces choix ont produit des signaux datés, traversé une simulation de portefeuille et affronté des contraintes de rendement, de drawdown, d’exposition et de taille d’échantillon.
Cette note explique la conception, les interactions qu’elle capture, le chemin commun entre recherche et production qui réduit les écarts, et la structure de recherche qui garde honnête un vaste espace joint. Il s’agit de méthodologie de recherche et d’ingénierie, pas d’une revendication d’avantage ni d’une promesse de rendements futurs.
Points clés
- En production, la sélection du screener et la gestion des trades forment un seul système. Les optimiser séparément revient à optimiser deux indicateurs indirects et à supposer que leur assemblage tient.
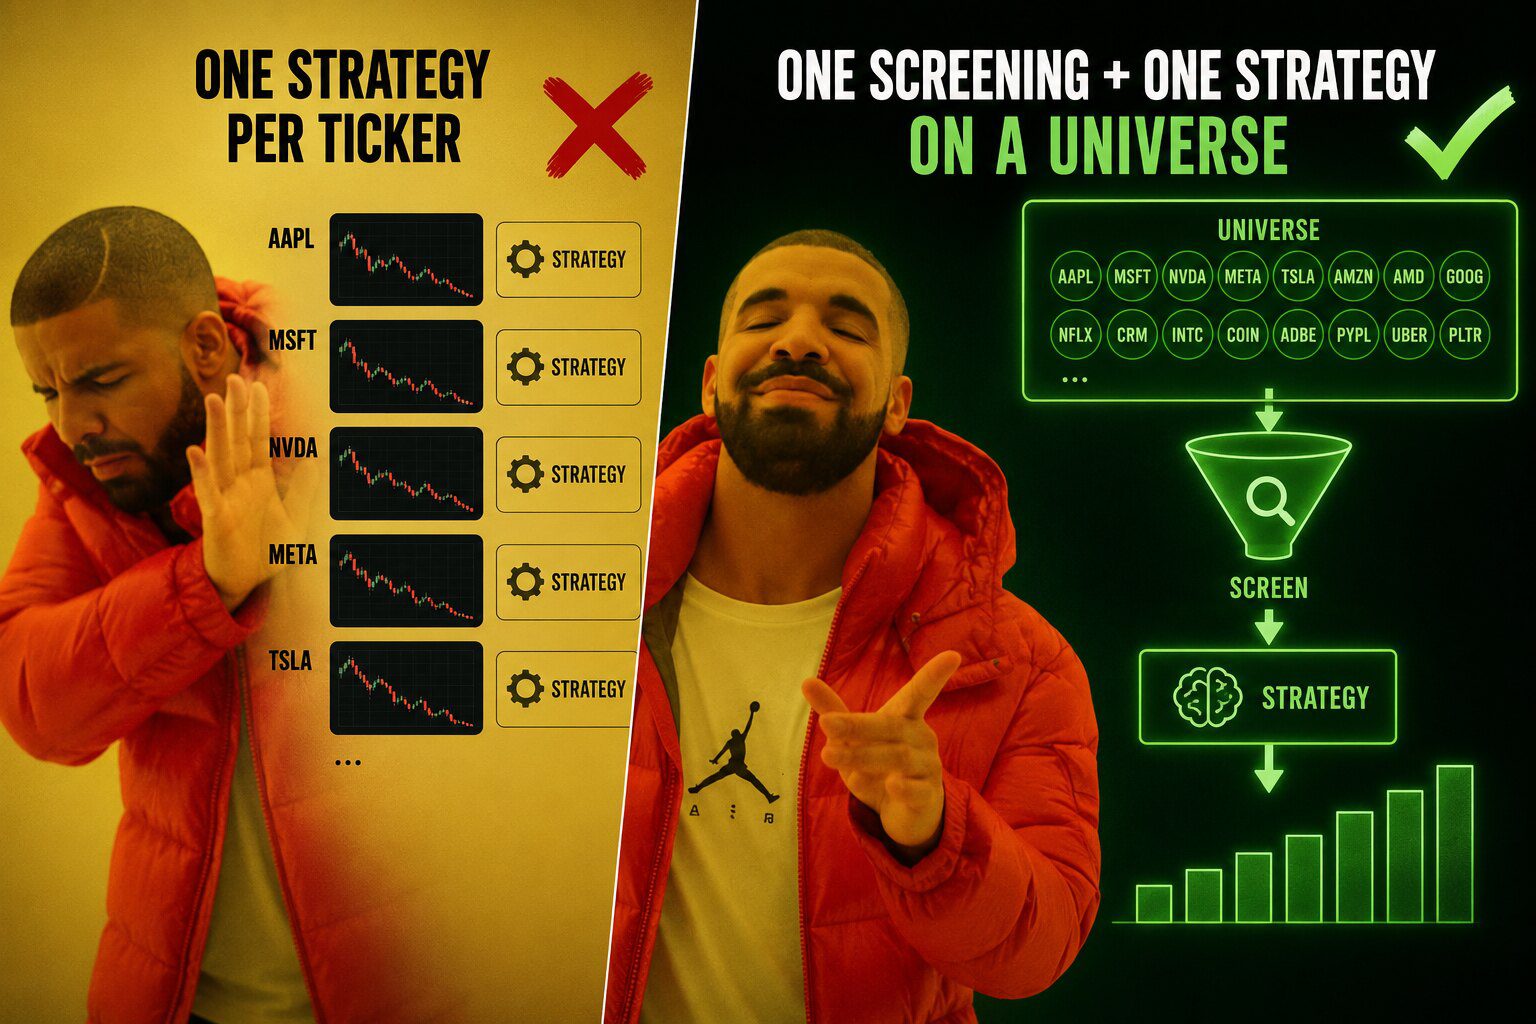
- Un candidat est une configuration unique appliquée à tout un univers. Rien n’est ajusté par ticker, et l’unité de temps n’est pas une dimension de recherche. Ce n’est pas un balayage symbole par unité de temps.
- Dans cette chaîne, un seul essai modifie ensemble les poids du score, les filtres d’entrée, les règles d’achat et de vente, les stops et les sorties de détention. La fitness n’est attribuée qu’après une simulation de portefeuille avec coûts, stops et barrières de risque.
- La recherche et le screening en direct appellent un seul moteur de signaux partagé. Cela supprime la dérive classique où un backtest réimplémente le screener dans un second dialecte et s’éloigne lentement de la production.
- Une recherche jointe naïve traite injustement les nouvelles paires de règles catégorielles, car chacune est d’abord jugée avec des poids ajustés pour la paire en place. Le remède : une optimisation interne par paire, une élimination successive par moitiés (successive halving), puis une passe jointe finale sur la liste restreinte.
- L’univers doit être construit en point-in-time, c’est-à-dire tel qu’il était à chaque date. Un optimiseur joint qui tourne sur un univers entaché de biais de survie ne fait qu’atteindre plus efficacement une mauvaise réponse.
- Le surapprentissage se trahit avant les statistiques : l’ensemble des justifications ne cesse de grossir. Fixez l’espace de décision, l’objectif et les seuils d’acceptation avant le run, pas après avoir vu la courbe.
- Aucune comparaison directe avec une chaîne séquentielle où le screener passe en premier n’est revendiquée ici. Les gains d’ingénierie réduisent le coût d’évaluation ; ils ne certifient aucun avantage.
Ce qu’est un candidat, et ce qu’il n’est pas
La question la plus fréquente sur cette conception est de savoir si « screener plus stratégie dans une seule boucle » signifie ajuster une configuration distincte pour chaque symbole, ou balayer une stratégie sur des symboles et des unités de temps pour trouver les combinaisons qui ont fonctionné. Ce n’est ni l’un ni l’autre, et la différence mérite d’être énoncée clairement avant toute mécanique, car les deux approches échouent de manières sans rapport entre elles.
Ici, un candidat est une configuration unique appliquée à l’ensemble de l’univers. Les mêmes poids de score, les mêmes filtres d’entrée, les mêmes règles d’achat et de vente et la même politique de stop et de détention s’appliquent à chaque titre admis par le screener. Le vecteur de décision décrit plus bas ne contient aucune dimension de symbole. Rien n’est réglé par ticker.
L’unité de temps n’est pas non plus une dimension de recherche. La taille des barres est fixée par l’étape de préparation des données et reste constante sur tout le run, si bien que l’optimiseur ne peut pas aller chercher la résolution qui aurait par hasard flatté une règle.
Au sein d’un candidat, la répartition des rôles est la suivante :
- Le screener décide de ce qui est éligible à chaque barre. Il note l’univers, applique les filtres de liquidité, de volatilité et de pente, et transmet l’ensemble admis.
- La stratégie décide du sort de ce que le screener a admis : moment d’entrée, stops, fenêtres de gel, limites de détention, sorties.
- Aucune des deux moitiés n’a son propre score. Une seule valeur de fitness revient par candidat, et c’est un résultat de portefeuille.
Comparez avec un balayage par symbole ou par unité de temps. Cette approche renvoie de nombreuses configurations au lieu d’une seule, et laisse derrière elle un problème de sélection non dit : il faut encore choisir quelle configuration trader, et ce choix se fait lui-même sur l’historique qui a produit les candidats. Elle multiplie aussi le nombre de comparaisons, si bien que la meilleure case d’une grille symbole par unité de temps est la case la plus susceptible de relever de la chance. Un candidat à l’échelle de l’univers, noté une seule fois au niveau du portefeuille, n’a pas de telle case à choisir : c’est tout l’intérêt de l’organisation illustrée ci-dessus.
Le coût caché des chaînes découplées
Une chaîne découplée optimise des indicateurs indirects, puis espère que leur assemblage tiendra. Modes d’échec typiques :
- Fitness indirecte. Le screener est noté sur la qualité du classement, le taux de réussite ou l’allure des graphiques. Aucun de ces critères n’équivaut au résultat du portefeuille après coûts, avec des sorties réelles.
- Paramètres partenaires figés. Quand vous réglez les entrées, les sorties restent fixes. Quand vous réglez les sorties, les entrées restent fixes. Les interactions n’entrent jamais dans la recherche.
- Dérive entre recherche et direct. Le backtest réimplémente les formules du screener. Un changement ultérieur en direct (ajustement de poids, plancher de filtre, dialecte de règles) ne se répercute pas automatiquement dans l’évaluation historique.
- Angles morts d’exécution. Une sélection qui ignore la distance des stops, les fenêtres de gel et les plafonds de détention sous-estime systématiquement le risque de rotation et surestime l’exposition productive.
Appelons cela le coût caché du découplage. Vous le payez en essais gaspillés, en fausse confiance tirée de métriques de classement in-sample, et en trades de production qui ne correspondent jamais tout à fait au notebook qui les a validés.
Ce que « unifié » signifie dans cette chaîne
Unifié ne veut pas dire « jeter tous les réglages dans une gigantesque recherche aléatoire ». Cela recouvre trois choix de conception concrets.
1. Un seul vecteur de décision mixte
Un essai est une configuration complète, pas un correctif appliqué au précédent. L’espace de décision mélange :
- 13 poids continus du screener qui construisent le score de tendance et de qualité et fixent les filtres : plage de NATR, score minimum, planchers de pente de long terme et de moyen terme, plancher de pente des volumes.
- Des expressions catégorielles de règles d’achat et de vente choisies dans un jeu de règles propre au domaine.
- Des variables de gestion des trades : stop suiveur, stop sur fenêtre de rétrospection, réglages de gel, durée maximale de détention, seuil de sortie de tendance.
L’optimiseur tire des réels, des entiers et des catégories dans un même essai, puis les décode en une charge d’évaluation complète. Le serveur d’évaluation restaure une base propre avant chaque candidat, de sorte que les essais restent cohérents au lieu d’être des mutations les uns des autres dépendantes du chemin parcouru.
2. Un seul moteur de signaux partagé entre recherche et screening en direct
Le screening en direct et l’évaluation historique construisent tous deux le même objet d’analyse avec les poids, les règles d’achat et de vente, les stops et les objectifs du candidat. Les deux appellent le même pipeline technique et la même fonction de signal. Les poids, les règles DSL, les filtres de liquidité et de volatilité, les planchers de pente, la symétrie long et short et le masquage des entrées selon le régime partagent une seule implémentation.
Cela n’efface pas toutes les différences entre direct et backtest. Le screening en direct lit toujours la clôture courante. Un backtest exécute normalement un signal à l’ouverture de la barre suivante. Le gain important est plus étroit : vous supprimez l’échec classique où l’optimiseur réimplémente le screener dans un second dialecte et s’éloigne de la production.
3. La fitness seulement après la simulation de portefeuille
Pour chaque candidat, l’évaluateur régénère les signaux par symbole sur tout l’univers, déroule la boucle temporelle du portefeuille avec coûts et allocation, applique les stops et les sorties de détention dans la gestion des positions, puis construit un objectif multi-métriques. Le vecteur renvoyé comprend un objectif combiné ainsi que des statistiques de rendement et de risque : CAGR, drawdown, Sharpe, Sortino, Calmar, stabilité, taux de réussite, nombre de trades, efficacité du capital, avantage de Kelly. Des barrières souples pénalisent l’excès d’exposition, l’ulcer index, le drawdown et les nombres de trades statistiquement trop faibles.
La qualité de la sélection n’est jamais notée sur de « jolis graphiques ». Elle est notée une fois que le réalisme d’exécution et les contrôles de risque ont eu leur mot à dire.
Pourquoi le couplage n’est pas optionnel
La sélectivité des signaux et la politique de sortie ne sont pas des réglages indépendants aux effets additifs.
- Relevez le score minimum et vous réduisez en général le nombre de trades. Cela ne fonctionne que si les stops et les limites de détention laissent encore un échantillon suffisant pour que les métriques de risque aient un sens.
- Relâchez les filtres d’entrée et la réussite moyenne des positions devient un problème de sortie : la distance du stop suiveur, le seuil de sortie de tendance et les fenêtres de gel dominent alors la rotation et le drawdown.
- Les paires de règles d’achat et de vente interagissent avec le vecteur de poids. Une paire de règles qui paraît faible avec des poids réglés pour une paire rivale peut paraître solide dès que ses propres poids et stops peuvent s’adapter.
Une recherche multivariée qui observe le résultat complet du portefeuille peut découvrir ces interactions. Une chaîne séquentielle « ajuster le screener, le figer, ajuster les sorties » maintient par construction la moitié partenaire constante. La formulation juste est prudente : l’architecture peut faire apparaître des interactions que le calibrage séquentiel maintient constantes. Cette note ne revendique aucun gain d’alpha ni de latence mesuré face à une référence séquentielle publiée. Aucune comparaison directe de ce type ne figure dans les éléments actuels du dépôt.
L’univers est lui aussi une variable de décision
Un couplage se situe en amont de tout ce qui précède. La boucle jointe note un candidat face à l’univers qu’on lui fournit. Si cet univers est construit à partir des titres qui ont survécu jusqu’à aujourd’hui, la boucle règle des règles de sélection sur un ensemble que personne n’aurait pu passer au screener à l’époque.
Le point a été formulé sans détour lors du panel Better System Trader de février 2024. Mike, qui gère un fonds de suivi de tendance depuis 2011, a placé la couche de sélection avant tout le reste :
Il faut une méthode de sélection qui choisit les instruments disponibles à l’époque. … Il vous faut ce screener qui balaie tous les marchés disponibles, puis qui passe au moment d’acheter, au moment de vendre, à la quantité à acheter et à vendre.
Mike, gérant d’un fonds de suivi de tendance, Better System Trader, épisode 223 (traduit de l’anglais)
Son exemple portait sur les futures : un test qui commence en 1980 ou 1985 omet en silence des contrats qui se traitaient alors et n’existent plus, et qu’un trader de l’époque aurait donc détenus. Il a ensuite nommé l’échec directement. Un univers assemblé aujourd’hui et rejoué à rebours n’est pas du tout un univers historique :
Pourquoi les auriez-vous sélectionnés en 1985 ? Pourquoi les auriez-vous sélectionnés en 1995, ou il y a cinq ans, dix ans ? Probablement pas. Donc il vous faut aussi la méthode de sélection. Vous ne pouvez pas ramener vos marchés actuels en arrière, parce que quand vous commencez votre test, vous les ramenez depuis le futur. Impossible.
Mike, gérant d’un fonds de suivi de tendance, Better System Trader, épisode 223 (traduit de l’anglais)
La version actions est venue juste après, sur le même panel : on backteste « les actions du S&P 500 » en ignorant que la composition de l’indice change, si bien que les valeurs qui ont composé leur croissance sont comptées et que les titres radiés n’apparaissent jamais. Kashyap, analyste fondamental présent sur le panel, a donné la version marketing grand public de la même erreur, en citant les publicités de fonds communs de placement indiens montrant ce que vaudrait aujourd’hui un investissement de 2014, et les articles qui calculent ce que mille dollars investis dans Nvidia seraient devenus. Personne n’aurait pu faire cette sélection à l’époque, d’où son jugement de publicités « complètement sorties de leur contexte ». Le même lecteur censé avoir acheté Nvidia aurait tout aussi bien pu acheter Pets.com.
Que le biais soit corrigeable ou non dépend de la classe d’actifs. Pavel, de Robuxio, qui gère des portefeuilles systématiques d’actions et de crypto, a tracé la limite là où les données s’arrêtent. Les traders actions peuvent acheter sur étagère, pour quelques dollars, une base de données sans biais de survie auprès d’un fournisseur comme Norgate. Les équivalents crypto, a-t-il noté, soit n’existent pas, soit sont assez confidentiels pour que la plupart des gens ne les trouvent jamais, ce qu’il considérait comme un problème majeur.
La conséquence pour une boucle unifiée est directe. Les poids du screener, les planchers de filtres et les paires de règles s’ajusteront à tout biais de survie que porte l’univers. Un objectif de bout en bout rend cet ajustement plus serré, pas plus sûr. Un optimiseur joint sur un univers contaminé est un moyen plus efficace d’atteindre une mauvaise réponse.
Deux exigences en découlent :
- L’appartenance à l’univers doit être évaluée à chaque barre, pas une seule fois au début du run. Les titres radiés, fusionnés ou rétrogradés doivent rester dans l’univers historique pendant la période où ils étaient négociables.
- La disponibilité des données varie fortement selon la classe d’actifs. L’historique point-in-time des composants est un problème commercial résolu pour les actions. Pas pour la crypto : cotations, radiations et paires mortes sont mal archivées, si bien qu’un univers reconstruit après coup porte un risque de biais de survie qu’aucune optimisation jointe ne supprime.
Cette note décrit l’architecture d’optimisation, pas la couche de données. Traitez la construction d’un univers point-in-time comme un prérequis distinct. S’il n’est pas résolu, la boucle ci-dessous mesure quelque chose de plus étroit qu’il n’y paraît.
Le surapprentissage a un signe : les justifications ne cessent de s’accumuler
Un optimiseur joint est, par sa structure, une machine à ajouter des justifications. Treize poids, une paire de règles catégorielles et une politique de stop offrent à une recherche de nombreuses façons d’expliquer une belle courbe de capital. Le même panel a décrit la version humaine de cet échec, qui vaut la peine d’être reprise car le signe se repère bien plus facilement chez une personne que sur une surface de perte.
Pavel a placé la cause profonde en premier, et ce n’est pas une erreur statistique :
Le curve fitting a beaucoup à voir avec les traders débutants qui essaient de devenir riches sur des données historiques. Ils ne pourront jamais trader l’historique. Quand je parle avec de nouveaux traders, ils pensent toujours aux données historiques comme si le futur allait être presque identique, ce qui ne sera jamais le cas. Il sera toujours très différent.
Pavel, de Robuxio, Better System Trader, épisode 223 (traduit de l’anglais)
Kashyap a décrit comment l’ajustement se trahit avant toute statistique, en prenant pour exemple les haussiers du pétrole de 2022. La thèse partait de deux chiffres, une demande d’environ 103 millions de barils par jour face à une offre d’environ 102, donc des stocks qui baissent et un prix qui monte. Puis elle s’est enrichie d’un pipeline endommagé, puis de perturbations sur le gaz naturel, et l’on a fini par tracer les prix de l’électricité allemands et norvégiens dans l’argumentaire d’un marché haussier permanent du pétrole. Son diagnostic de cette dérive est la partie transposable :
Quand vous voyez ce genre de glissement dans les statistiques que vous regardez pour justifier votre thèse, c’est là que vous savez que vous entrez dans la phase de surapprentissage, parce que vous ajoutez de plus en plus d’informations qui ne sont pas vraiment pertinentes mais qui vous aident un peu à défendre votre thèse.
Kashyap, analyste fondamental, Better System Trader, épisode 223 (traduit de l’anglais)
Il a donné un second exemple à plus petite échelle. Une lettre d’information minière, réputée pour dénicher des small caps, en était arrivée dans son numéro d’août 2007 à resserrer son argumentaire sur la disponibilité des appareils de forage et des laboratoires d’analyse. Quand une thèse descend à ce niveau de détail, a-t-il suggéré, un sommet est généralement proche. Les deux exemples partagent une structure qu’il vaut la peine de nommer : la base de preuves grossit tandis que la conclusion reste fixe.
Mike a fourni le test opérationnel. Il ne coûte rien, et c’est précisément la vérification qu’aucune boucle de recherche ne peut faire à votre place :
L’expérience aide aussi là-dessus. Si vous avez déjà en tête la réponse que vous voulez, vous avez probablement un problème. Il faut rester honnête entre « voyons si ça marche » et « je veux que ça marche, alors faisons en sorte que ça marche ».
Mike, gérant d’un fonds de suivi de tendance, Better System Trader, épisode 223 (traduit de l’anglais)
Transposé à cette architecture, le risque n’est pas que l’optimiseur manipule de nombreux paramètres. C’est que le chercheur continue d’en ajouter après avoir vu le résultat, puis présente la dernière configuration comme si elle avait été spécifiée en premier. Fixer l’espace de décision, l’objectif et les seuils d’acceptation avant un run, c’est ce qui distingue une recherche jointe d’un ensemble de justifications qui enfle. C’est tout l’objet des contraintes décrites plus bas, dans la section sur ce qui reste fixe à dessein.
Comment se déroule un cycle d’évaluation
Sans la tuyauterie, le cycle est court :
- Construire un seul espace de décision mixte : poids, stops, objectifs de durée et de tendance, réglages de gel, indices d’achat et de vente.
- Tirer un essai complet et le décoder en un tuple d’évaluation.
- Sur le serveur d’évaluation, restaurer une base propre, appliquer les règles et les réglages de gestion des trades, appliquer les poids, lancer l’évaluation de l’étape.
- Régénérer des signaux long et short datés sur tout l’univers avec le moteur de signaux partagé.
- Simuler le portefeuille : allocation, coûts, stops, limites de détention, sorties de tendance.
- Renvoyer les métriques et les pénalités de barrière sous la forme d’un vecteur d’objectif unique, pour une sélection mono-objectif ou un run de Pareto multi-objectif.
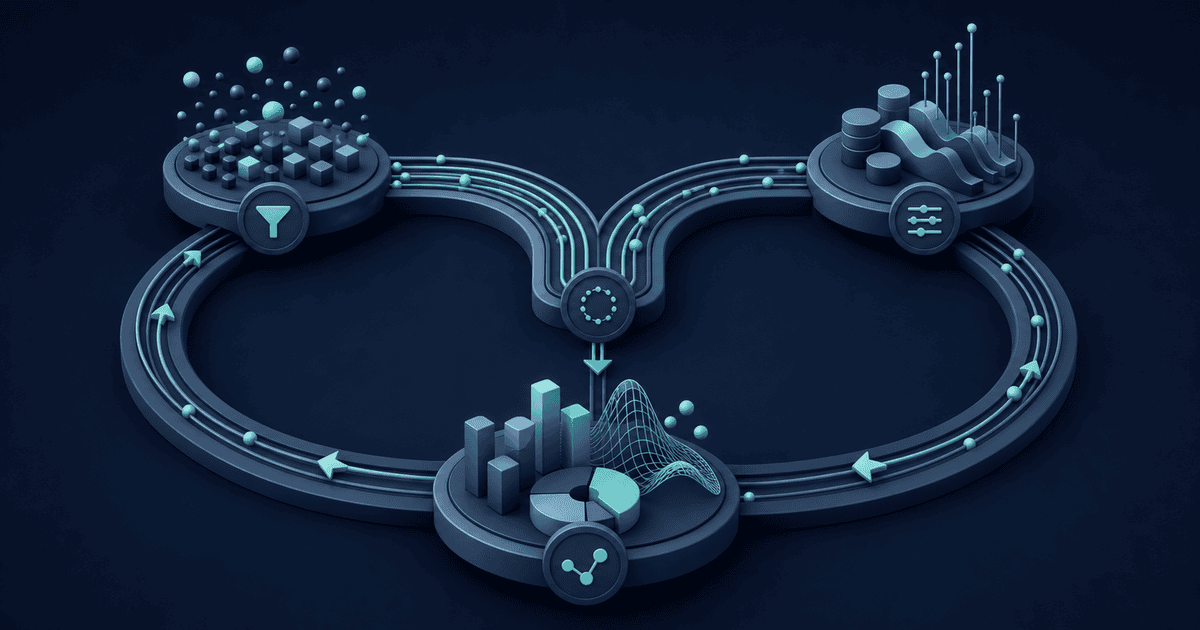
Flux résumé :
[score weights + entry/exit rules + stop/holding parameters]
                |
                v
     shared signal generation (same as live screener)
                |
                v
      dated entries/exits across the universe
                |
                v
 portfolio simulation, costs, stops, allocation
                |
                v
metrics + risk / trade-count barrier penalties
                |
                v
      scalar objective or Pareto vector
L’ingénierie qui rend la boucle praticable
L’évaluation de bout en bout ne fonctionne que si chaque essai coûte assez peu pour être relancé souvent. La chaîne dépense son calcul une seule fois partout où c’est possible :
- Préparer les données et les indicateurs réutilisables une seule fois avant de servir les tâches des candidats. Les essais se contentent normalement d’évaluer ; ils ne rechargent pas l’historique de marché.
- Partager les frames préparées entre les workers avec des données en lecture seule et en copie sur écriture, pour que les processus recyclés sautent la préparation.
- Paralléliser sur deux axes : des essais simultanés côté optimiseur, et la génération de signaux par symbole au sein d’un essai.
- Mettre en cache les clés complètes des candidats pour que les configurations en double ne paient pas un aller-retour superflu.
- Échouer vite sur les régions impossibles (par exemple un minimum de NATR qui n’est pas inférieur au maximum) avant la génération des signaux.
- Précalculer l’état de régime global une fois par tâche à partir de la série du marché large et le transmettre à chaque symbole, au lieu de recalculer le même contexte de marché pour chaque titre.
- Utiliser des opérateurs de recherche adaptés au type : croisement continu pour les poids et les stops, échange catégoriel pour les indices de règles, afin que des étiquettes entières adjacentes ne soient pas traitées comme de proches voisines quand l’ordre des indices n’a aucun sens.
Ce sont des avantages de calcul. Ils ne prouvent pas que la stratégie obtenue est plus rentable. Considérez-les comme la structure de coûts qui rend abordable un objectif de bout en bout honnête.
Ne survendez pas une recherche jointe naïve
Une conception unifiée honnête admet un vrai mode d’échec. Si vous libérez en même temps toutes les paires d’achat et de vente et tous les poids, la recherche peut s’embrouiller. Une nouvelle paire de règles est souvent testée d’abord avec des poids encore adaptés à la paire en place. Elle paraît faible, est écartée et ne reçoit jamais un budget de calibrage équitable. Des runs passés dans ce code ont concentré une large part des évaluations sur une seule paire, même après les garde-fous de croisement mixte et d’échantillonnage parallèle.
Il existe une version plus dure de cette critique, qui mérite d’être énoncée. Sur le même panel, Pavel, de Robuxio, a décrit la conception opposée : aucune optimisation de paramètres.
Je suis allé jusqu’à la simplification extrême. Je n’optimise jamais aucun paramètre dans une stratégie de trading. Mes stratégies, c’est une condition d’entrée, une condition de sortie et un filtre de régime, plus un classement. J’essaie de garder tout aussi simple que possible au niveau de chaque stratégie, et d’aller un peu plus loin au niveau du portefeuille. C’est comme ça que je me suis totalement débarrassé du besoin d’une forme de surapprentissage.
Pavel, de Robuxio, Better System Trader, épisode 223 (traduit de l’anglais)
Avec cette conception, la complexité ne disparaît pas, elle se déplace. La stabilité se construit au niveau du portefeuille, en faisant tourner du retour à la moyenne à côté du suivi de tendance pour que des stratégies faiblement corrélées puissent partager le même capital. D’après lui, la simplification a découlé de cette découverte au lieu de la précéder : une fois que la combinaison au niveau du portefeuille faisait le travail, le réglage au niveau de chaque stratégie a cessé d’être rentable.
Il a aussi désigné une source de décorrélation qui n’exige aucune recherche nouvelle, et c’est la partie de sa position la plus difficile à contester sur le terrain des coûts :
Vous pouvez en gros avoir la même stratégie, et si vous la faites tourner sur une petite unité de temps, genre 3 fois plus petite à peu près, le coefficient de corrélation peut descendre à 0,3, 0,25, ce qui est très intéressant. Vous n’avez besoin de rien trouver d’autre, vous pouvez simplement réutiliser la même stratégie sur une unité de temps un peu plus basse et obtenir des résultats assez différents.
Pavel, de Robuxio, Better System Trader, épisode 223 (traduit de l’anglais)
L’argument est qu’une stratégie jamais ajustée ne peut pas être surajustée, et que la corrélation entre stratégies est un levier plus fiable que la qualité des paramètres. Cette position est cohérente, et une boucle de recherche plus intelligente n’y répond pas. Seules les données hors échantillon y répondent : le candidat joint ajusté doit tenir là où le candidat simple non ajusté ne tient pas. À noter que le chiffre de 0,25 à 0,3 est le souvenir d’un praticien lors d’un panel en direct, pas une mesure publiée, et qu’une corrélation estimée sur un court historique crypto est elle-même instable.
L’échec à l’autre extrême mérite aussi d’être mentionné, car c’est à cela que ressemble un objectif sans contrainte quand quelqu’un cesse de se poser des questions. Jason, d’Against All Odds Research, a décrit un fonds qui croyait avoir complètement éliminé les années perdantes :
Ils m’appellent et me disent : j’ai trouvé ce système, il gagne à chaque fois, on gagne toujours de l’argent. Je réponds : c’est impossible, et pour moi ça ressemble à quelqu’un qui est sur le point de sauter. Et lui : non non, il gagne à chaque fois, il ne perd jamais d’argent. Alors je dis : envoie-moi ce que tu fais et je vais le backtester. Et là : mec, ce système saute en fait tous les quatre ou cinq ans, de quoi tu parles ? Il me répond : ah, il faut juste prévoir la récession, et après ça va.
Jason, d’Against All Odds Research, Better System Trader, épisode 223 (traduit de l’anglais)
Le système ne gagnait pas à chaque fois. Il portait une hypothèse de régime non dite, et cette hypothèse faisait le travail que le backtest semblait faire. Un objectif joint n’aide ici que si les contraintes de barrière et la fenêtre d’évaluation sont assez larges pour contenir le régime dans lequel se cache l’hypothèse. KreamEdge n’a pas vérifié ce récit, et aucun fonds n’est nommé sur le panel ; il est rapporté tel qu’il a été raconté.
Le remède pratique est un processus à deux niveaux, pas un repli vers des objectifs entièrement découplés :
- Donner à chaque paire candidate d’achat et de vente sa propre optimisation interne, pour que les poids et les sorties puissent s’adapter à cette paire.
- Utiliser l’élimination successive par moitiés pour garder les paires les plus solides et abandonner les autres tôt.
- Lancer l’optimisation jointe finale avec les poids, les sorties et les gènes de paire libres, mais uniquement sur cette liste restreinte.
Voilà l’affirmation défendable. Évaluer la sélection du screener et la gestion des trades avec le même objectif de bout en bout. Structurer la recherche pour que les stratégies catégorielles reçoivent un budget de calibrage équitable. L’objectif unifié d’abord. Une géométrie de recherche équitable ensuite.
Ce qui reste fixe à dessein
Tout n’est pas une variable libre, et c’est voulu :
- Les seuils de régime peuvent servir de contexte au niveau du serveur plutôt que de gènes propres à chaque candidat, pour que l’optimiseur ne réétiquette pas discrètement les états de marché à la poursuite d’une chance in-sample.
- Des poids éprouvés peuvent être figés pour réduire la dimensionnalité une fois qu’une région a été soumise à des tests de résistance.
- Les expressions de stratégie ne peuvent changer que si la phase de préparation a déjà matérialisé toutes les familles d’indicateurs nécessaires. Sinon, la tâche échoue en mode fermé et demande un redémarrage avec un jeu de préparation suffisant.
Ce type de contraintes empêche la boucle jointe de devenir une fabrique d’histoires sans limite.
Ce que cela change pour qui construit sa chaîne
Si vous construisez votre propre chaîne systématique, les enseignements utiles sont opérationnels, pas doctrinaux :
- Notez la sélection après la simulation de portefeuille, pas avant.
- Partagez une seule implémentation des signaux entre la recherche et le screening en direct.
- Traitez la sélectivité des entrées et la politique de sortie comme un seul système couplé lors de la recherche.
- Payez le coût d’ingénierie du « préparer une fois, évaluer souvent », sinon la boucle jointe reste trop chère pour être menée honnêtement.
- Si l’espace comprend des paires de règles catégorielles, donnez à chaque paire un vrai budget de calibrage avant la passe jointe finale. L’élimination successive par moitiés est un schéma pratique.
- Préférez les objectifs multi-métriques et les fronts de Pareto quand rendement et risque s’arbitrent. Cachez moins de choses dans un score unique arbitraire.
- Construisez l’univers en point-in-time avant d’y régler quoi que ce soit. Le biais de survie de l’ensemble des candidats est directement absorbé par les poids du screener.
- Éprouvez le gagnant en retirant des données, pas seulement en mettant la fin de l’historique de côté. Coupez un tiers de l’historique, décalez les dates de début et de fin, et relancez. Une boucle jointe rend cette vérification peu coûteuse face à l’objectif complet de bout en bout, au lieu d’un indicateur indirect de classement.
Ce dernier point est sorti du panel comme une règle empirique plutôt qu’un test formel, et Mike l’a énoncé dans les termes les plus simples possibles :
Si vous avez deux règles, si vous retirez un tiers des données, comment ça change ? Si les statistiques de performance ne changent pas beaucoup, disons 10 %… si ça change de plus de 10 %, vous avez peut-être quelque chose de pas très solide.
Mike, gérant d’un fonds de suivi de tendance, Better System Trader, épisode 223 (traduit de l’anglais)
Il l’a étendu aux dates de début et de fin : décalez-les, retirez un gros bloc d’historique, et cherchez des résultats qui se regroupent dans la même zone au lieu de se disperser. Il l’a ensuite associé à une seconde vérification qu’une chaîne pilotée par un screener devrait trouver nettement inconfortable, car elle s’attaque à l’univers plutôt qu’aux paramètres. Confiez les règles à quelqu’un d’autre pour qu’il les fasse tourner sur des instruments sur lesquels elles n’ont jamais été réglées. Des règles ajustées sur une poignée de titres récents à fort momentum survivent rarement au transfert, parce que, selon sa formule, « ces règles sont pour ces marchés, à ce moment-là ».
Aucune des deux vérifications n’est un test de significativité, et aucune ne remplace un protocole walk-forward. Ce sont des premiers filtres peu coûteux, et un évaluateur unifié les rend encore moins chers, car le même objectif de bout en bout peut être recalculé sur un historique tronqué ou un univers échangé sans mettre en place une référence de classement distincte à laquelle se comparer.
Rien de tout cela ne vous oblige à adopter ce code. Cela vous oblige en revanche à cesser de faire comme si un excellent modèle de classement et un excellent modèle de sortie se combinaient automatiquement en un excellent processus de portefeuille.
Limites
Gardez les affirmations à l’intérieur des preuves :
- Ceci décrit une architecture d’optimisation de bout en bout dont l’application est garantie par le code, pas un tournoi de benchmarks indépendant.
- Aucune comparaison directe examinée ne montre d’accélération chiffrée ni de gain de rendement de l’approche « unifiée » face à une chaîne séquentielle où le screener passe en premier. N’en inventez pas.
- Les gains de calcul (préparation unique, partage des frames entre workers, cache des candidats, rejet précoce, précalcul du régime) réduisent le coût d’évaluation. Ils ne certifient aucun avantage.
- Les métriques de portefeuille passées de tout rapport de backtest associé restent historiques. Elles ne garantissent pas les résultats futurs.
Le créneau méthodologique de KreamEdge est la robustesse sous réalisme d’exécution. Cela ne tient que si la rédaction reste aussi rigoureuse que l’évaluateur.
Questions fréquentes (FAQ)
Qu’est-ce que l’optimisation jointe du screener et de la stratégie ?
L’optimisation jointe du screener et de la stratégie signifie qu’un seul essai de recherche modifie en même temps la couche de sélection et la couche de gestion des trades, puis reçoit un score unique. Les poids du score, les filtres d’entrée, les règles d’achat et de vente, les stops, les fenêtres de gel et les limites de détention font tous partie d’un même vecteur de décision, et la fitness n’est attribuée qu’une fois que ces choix ont généré des signaux datés et traversé une simulation de portefeuille avec coûts et contraintes de risque. L’alternative, qui consiste à régler un screener sur la qualité du classement et à confier sa sortie à un modèle de sortie réglé séparément, optimise deux indicateurs indirects et suppose que les deux moitiés s’assemblent.
Est-ce la même chose qu’optimiser une stratégie par symbole ou par unité de temps ?
Non. Dans cette conception, un candidat est une configuration unique appliquée à tout un univers : les mêmes poids de score, filtres d’entrée, règles d’achat et de vente et politique de stop s’appliquent à chaque titre admis par le screener, et le vecteur de décision ne contient ni dimension de symbole ni dimension d’unité de temps. La taille des barres est fixée par l’étape de préparation des données au lieu d’être recherchée. Un balayage par symbole ou par unité de temps fait l’inverse : il renvoie une configuration ajustée par combinaison, ce qui laisse un problème de sélection derrière lui, car il faut encore choisir quelle configuration trader en utilisant l’historique même qui les a toutes générées. Il multiplie aussi le nombre de comparaisons, si bien que la case la plus forte d’une grille symbole par unité de temps est la case la plus susceptible de relever de la chance plutôt que d’un avantage.
Pourquoi ne pas optimiser d’abord le screener, puis les règles de trading ?
Parce que la sélectivité et la politique de sortie interagissent au lieu de s’additionner. Relever un score minimum réduit le nombre de trades, ce qui n’aide que si les stops et les limites de détention laissent encore un échantillon suffisant pour que les statistiques de risque aient un sens. Relâcher les filtres d’entrée transforme la réussite des positions en problème de sortie, où la distance du stop suiveur et les seuils de sortie de tendance se mettent à dominer la rotation et le drawdown. Une chaîne séquentielle fige une moitié pendant qu’elle règle l’autre, si bien que ces interactions n’entrent jamais dans la recherche, par construction.
L’optimisation jointe augmente-t-elle le risque de surapprentissage ?
Elle augmente le nombre de façons dont une recherche peut expliquer une belle courbe historique, donc la réponse honnête est oui, sauf si le protocole est fixé à l’avance. Les parades qui comptent : déclarer l’espace de décision, l’objectif et les seuils d’acceptation avant le run, figer les seuils de régime et les poids éprouvés comme contexte au niveau du serveur plutôt que comme gènes libres, appliquer des pénalités souples aux nombres de trades trop faibles et à l’excès de drawdown, et tester le gagnant en retirant des données plutôt qu’en mettant seulement la fin de l’historique de côté. Un espace de recherche plus grand n’est pas le danger ; réviser la spécification après avoir vu le résultat l’est.
Qu’est-ce qu’un univers point-in-time et pourquoi compte-t-il pour un screener ?
Un univers point-in-time contient, à chaque barre historique, exactement les instruments réellement négociables à cette barre, y compris les titres ensuite radiés, fusionnés ou retirés d’un indice. Il compte davantage pour un screener que pour une stratégie mono-instrument, car les règles de sélection s’ajustent à tout biais de survie que porte l’ensemble des candidats. L’historique point-in-time des composants est un problème commercial résolu pour les actions et largement non résolu pour la crypto, où les paires mortes et les radiations sont mal archivées. Un objectif de bout en bout appliqué à un univers contaminé rend le mauvais ajustement plus serré, pas plus sûr.
Comment vérifier qu’une stratégie optimisée conjointement est stable ?
Deux vérifications peu coûteuses passent avant tout protocole formel. Retirez une grosse part de l’historique, environ un tiers, décalez les dates de début et de fin, et relancez ; si les statistiques de performance bougent de bien plus de dix pour cent environ au lieu de se regrouper, la configuration est probablement fragile. Faites ensuite tourner les mêmes règles sur un panier hors échantillon d’instruments sur lesquels elles n’ont jamais été réglées, car des règles ajustées sur une poignée de titres récents à fort momentum se transfèrent rarement. Aucune des deux vérifications n’est un test de significativité et aucune ne remplace une analyse walk-forward ; ce sont des premiers filtres qu’un évaluateur unifié rend peu coûteux à répéter.
Une stratégie optimisée conjointement vaut-elle mieux qu’un portefeuille de stratégies simples non optimisées ?
Cette note n’affirme rien de tel, et la conception opposée est sérieuse. Certains praticiens n’optimisent jamais aucun paramètre, utilisent une condition d’entrée, une condition de sortie et un filtre de régime, et construisent la stabilité en combinant au niveau du portefeuille des stratégies simples faiblement corrélées, au motif qu’une stratégie jamais ajustée ne peut pas être surajustée. Une meilleure boucle de recherche ne réfute pas cette position. Seules les données hors échantillon tranchent, en montrant si le candidat joint ajusté tient là où le candidat simple non ajusté ne tient pas.
Sources
Les arguments de praticiens cités plus haut sur les univers point-in-time, le biais de survie, le signe du surapprentissage, les tests de stabilité par retrait de données et la position contraire sans optimisation proviennent tous d’une seule discussion publique :
- Better System Trader, épisode 223, « The Trading Panel » épisode 1, février 2024, animé par Andrew Swanscott avec Jason d’Against All Odds Research, Pavel de Robuxio, Kashyap, Mike et Markets & Mayhem. Écouter l’épisode.
- Better System Trader sur YouTube : la chaîne propose les versions vidéo du panel et les archives des entretiens.
Sur les sources : les passages en citation et entre guillemets sont transcrits mot pour mot de l’audio de l’épisode, nettoyés de la ponctuation, des mots de remplissage et des erreurs de transcription évidentes, mais jamais sur le fond, avec des points de suspension pour signaler toute coupure ; ils sont ici traduits de l’anglais. Tout le reste de ce qui est attribué à un intervenant est une paraphrase de son argument dans les mots de KreamEdge. L’enregistrement ne comporte pas d’identification des intervenants, si bien que l’attribution est déduite des interpellations directes et des présentations dans la conversation ; lorsqu’une prise de parole était ambiguë, le point est rapporté sans nom. Les intervenants sont identifiés par le prénom et l’affiliation donnés à l’antenne, et aucun nom de famille n’est ajouté au-delà de ceux que l’épisode donne lui-même.
KreamEdge n’a aucun lien avec Better System Trader, ses invités ou les auteurs cités, et aucune citation ne vaut recommandation. L’épisode contient des mentions non rémunérées de fournisseurs et un code de réduction pour un logiciel de backtest tiers ; aucun de ces produits n’est recommandé ici.
Conclusion
En production, la sélection du screener et la gestion des trades forment un seul système. Les traiter en recherche comme deux passages de relais administratifs est une fiction commode. L’optimisation jointe avec un moteur de signaux partagé, une fitness au niveau du portefeuille et une structure de recherche « liste restreinte puis passe jointe » est la façon dont cette chaîne supprime cette fiction sans transformer la recherche en mêlée sans budget.
Pour lire les notes de recherche associées et suivre les discussions de la communauté sur la méthodologie des backtests, rejoignez les canaux gratuits de la page communauté. Tout ce qui s’y trouve reste informatif et pédagogique. Ceci n’est pas un conseil en investissement.
Recherches KreamEdge associées
- Pourquoi les backtests de trading par LLM sont (pour la plupart) absurdes (en anglais)
- Déflateur de liquidité SPX : corriger un biais silencieux dans les backtests longs (en anglais)
- Dimensionnement des positions : un résultat nul (en anglais)
- Filtre de régime de marché : un résultat nul (en anglais)
- Portefeuille 1D combiné actions américaines et indices mondiaux (Backtest 332) (en anglais)
- La gestion du risque après la débâcle de l’IA : volatilité et biais (en anglais)
- Combien de trades par paramètre un backtest exige (en anglais)
- SSE en production : construire un flux de signaux fiable (en anglais)
0 commentaire