Une fois une stratégie écrite, la plus grande question ouverte est rarement quel signal se déclenche. C’est combien de capital engager quand il se déclenche. Cette décision, le dimensionnement des positions, fixe le taux de croissance géométrique du compte, le profil de drawdown et la variance des rendements bien plus que le choix de l’indicateur.
Cet article compare trois règles de dimensionnement utilisées dans le moteur KreamEdge. Elles ne sont pas des barreaux sur une échelle de sophistication ; elles visent trois objectifs différents :
- Fraction fixe : attribue une fraction fixe du capital à chaque entrée. Aucun objectif au-delà de la simplicité.
- Kelly : maximise le taux de croissance géométrique à long terme du capital, conditionnellement à l’avantage et à la variance par pari de la stratégie.
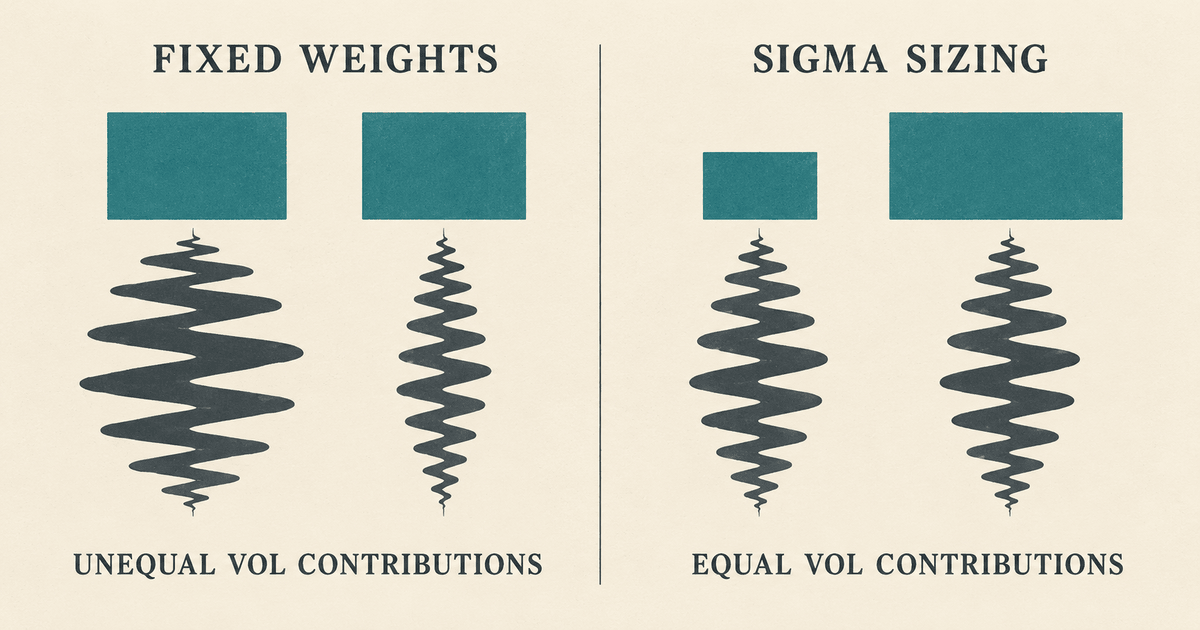
- Ciblage sigma (inverse de la volatilité) : dimensionne chaque position pour que sa contribution ex ante à la volatilité soit la même. Vise une contribution au risque égale par titre, pas la croissance.
Sigma ne domine Kelly en aucun sens bien défini. Ils répondent à des questions différentes. La thèse de cet article est que, dans des conditions opérationnelles réalistes, les données d’entrée dont Kelly a besoin ne sont pas disponibles à un coût assez faible pour compter, et que le ciblage sigma et une référence solide (la fraction fixe) finissent par être les règles qui survivent réellement au contact de la production.
Cet article présente aussi un A/B sur plusieurs versions du banc KreamEdge, à travers quatre instantanés du moteur, qui isole (a) l’activation de sigma sans rien changer d’autre, (b) sigma plus une réoptimisation annoncée, et (c) sigma plus réoptimisation plus élagage du vecteur de poids du score. Le résultat le plus net est le troisième. Les autres sont plus faibles qu’une première lecture ne le laissait penser, et cet article explique clairement pourquoi.
Mise à jour de novembre 2026 : KreamEdge utilise désormais un dimensionnement fixe
Depuis le 12 octobre 2026, le moteur KreamEdge utilise par défaut un dimensionnement à fraction fixe, à la fois dans le backtest et dans le pipeline de signaux. Le ciblage sigma reste implémenté mais désactivé par défaut, et un avertissement s’affiche partout où il est activé. Les raisons sont opérationnelles. Le banc du §5 ne parvient toujours pas à départager les deux règles, si bien que la règle la moins coûteuse à faire tourner correctement l’a emporté.
Trois raisons opérationnelles ont motivé ce changement :
- La stratégie reste indépendante de l’exécution. Une stratégie KreamEdge émet un signal qui porte une taille visée par unité de capital, et le côté exécution se contente de l’adapter au compte. Un poids fixe n’a besoin de rien d’autre. Un budget de risque sigma appliqué aux positions ouvertes exigeait que des estimations de volatilité fraîches circulent du côté signal vers le côté exécution à chaque run, et ce canal apportait des valeurs périmées, des changements de schéma et du volume d’écriture. Il a été supprimé.
- Les unités de volatilité suivent la taille des barres. L’estimation sigma est calculée sur les barres sur lesquelles tourne la stratégie. Un budget libellé « pourcentage de la valeur liquidative par jour » n’est exact que sur des barres quotidiennes ; sur des barres horaires, il devient un budget par barre, si bien que le même réglage sigma correspond à un risque différent pour une stratégie en 1 heure et pour une stratégie quotidienne. Un poids fixe signifie la même chose sur toutes les unités de temps.
- Les résultats ne justifiaient pas la complexité. Le contraste le plus net du §5 (de A à B, sigma activé sans aucun autre changement) plaçait l’effet dans le bruit, et le §6 concluait déjà que la règle la plus simple l’emporte quand le choix revient au même.
Pourquoi KreamEdge s’attend toujours à revenir à sigma. L’argument des §3 et §6 n’a pas changé. Dès qu’un même portefeuille mélange des titres aux volatilités très différentes, comme des actions individuelles, des ETF et de la crypto, une contribution au risque égale par titre est la bonne couche de base, et des poids fixes laissent les titres les plus volatils dominer le risque. KreamEdge prévoit de revenir à sigma quand trois conditions seront réunies : l’estimation de volatilité utilise une seule unité quelle que soit l’unité de temps, tout budget de risque sur les positions ouvertes lit une base dédiée de volatilité à l’état courant au lieu de l’historique des signaux, et un A/B propre avec optimisation à neuf départage les deux règles sur le banc. D’ici là, le dimensionnement fixe reste la valeur par défaut.
1. Le dimensionnement à fraction fixe
La règle la plus simple : chaque entrée reçoit un poids cible fixe w du capital. Si w = 10 % et que le capital vaut 1 000 000, chaque nouvelle position est dimensionnée à 100 000 de notionnel. Quand le capital augmente ou diminue, la taille absolue du pari suit. C’est un dimensionnement géométrique (composé), pas un montant fixe en dollars.
Avantages
- Un seul nombre, aucune erreur d’estimation.
- Trivial à auditer.
- Se comporte bien quand vous ne savez pas ce que vous ignorez (petit échantillon, changements de régime).
Inconvénients
- Traite une microcap à 60 % de volatilité comme une grande capitalisation à 12 %. La contribution au risque par position est extrêmement inégale.
- Ignore l’avantage : une entrée avec une espérance de 0,9 reçoit la même taille qu’une entrée à 0,3.
- Le drawdown est dominé par le sous-ensemble de positions le plus volatil du moment.
Le dimensionnement fixe est la référence honnête. Beaucoup d’affirmations du type « Kelly améliore les choses » dans la littérature sur le trading s’effondrent quand on remplace la comparaison par un run à fraction fixe correctement réglé.
2. Le dimensionnement de Kelly, et pourquoi le Kelly de backtest dégénère en pratique
La formule de Kelly, dans sa forme à utilité logarithmique et à pari unique :
f* = edge / variance
Pour un pari binaire gagnant/perdant avec une probabilité de gain p et un ratio gain:perte b :
f* = (p·b − (1 − p)) / b
Appliquez cela à une stratégie dont le backtest a produit un taux de réussite agrégé p et un R:R moyen b, et vous obtenez un seul nombre. Ce nombre est constant pour tous les signaux, car les données d’entrée sont des statistiques agrégées sur l’ensemble du backtest. Dans le cadre d’un pari unique IID, le Kelly de backtest se réduit à un dimensionnement à fraction fixe avec un scalaire implicite de Kelly (p·b − (1 − p))/b. Et comme le p de backtest est en général biaisé à la hausse par rapport au p réel (slippage, ordres non exécutés, exécutions partielles), ce scalaire est lui aussi biaisé à la hausse. La forme se ramène à la fraction fixe ; la taille est systématiquement trop agressive.
Deux réserves avant de pousser cette affirmation trop loin :
- Le Kelly multi-actifs n’est pas constant. Avec des paris simultanés et une vraie matrice de covariance
Σ, les poids optimaux pour la croissance sontw* ∝ Σ⁻¹ μ. Ils dépendent réellement de l’état à traversΣ. L’argument de la réduction à une constante ne tient que dans la projection à pari unique que supposent la plupart des articles de blog grand public. Il faut quand même estimerμetΣà partir de l’historique, donc la critique opérationnelle ci-dessous s’applique, mais la formule elle-même n’est pas un scalaire. - Le « Kelly fractionnaire » (moitié, quart) est fondé en principe, pas un bricolage. MacLean/Thorp/Ziemba (2011) montrent que lorsque l’erreur type de votre estimation d’avantage est du même ordre que l’avantage lui-même, le dimensionnement optimal au sens bayésien est d’environ un demi-Kelly. Ce rétrécissement est la bonne réponse à un bruit connu sur les données d’entrée. Ce n’est pas « j’ai abandonné et choisi un nombre ».
La raison pour laquelle le Kelly de backtest nuit plus qu’il n’aide en pratique est la sensibilité aux données d’entrée. Pour un pari binaire, ∂f*/∂p = (b + 1)/b. Avec b = 2, cela fait 1,5. Une surestimation de 3 points du taux de réussite gonfle f* d’environ 4,5 points de capital. Avec b = 3, d’environ 4 points. Les stratégies systématiques réelles ont couramment des estimations de taux de réussite avec des erreurs types de 3 à 5 points sur un échantillon de backtest de 5 ans, ce qui signifie que la bande d’erreur due à l’échantillon du Kelly complet noie le signal.
Bilan : le Kelly sur backtest agrégé est une fraction fixe sous une justification de Kelly, avec un scalaire biaisé vers le surendettement. Le Kelly conditionnel est une règle réellement différente : des estimations d’avantage par signal (tranches de force du signal, a priori de régime, taux de réussite réel ajusté du slippage) rendent f* dépendant de l’état, et c’est dans ce conditionnement que réside son véritable avantage. C’est un choix institutionnel défendable quand ces données existent. Sans elles, il reste une fraction fixe avec de la paperasse en plus : l’inconvénient de la sensibilité aux données d’entrée de Kelly sans le bénéfice du conditionnement.
3. Le ciblage sigma (inverse de la volatilité)
La règle : dimensionner chaque position pour que sa contribution ex ante à la volatilité du portefeuille corresponde à un budget fixe. Dans l’abstrait :
target_fraction = (daily_vol_budget_pct / 100) / sigma_daily
où sigma_daily est un écart type lissé par EMA des rendements quotidiens du sous-jacent, relevé au moment du signal, et daily_vol_budget_pct est le budget de volatilité quotidienne par titre, en pourcentage de la valeur liquidative. Un réglage de 0,25 % signifie que chaque nouvelle entrée doit contribuer à 0,25 % de la valeur liquidative en volatilité quotidienne attendue, soit environ 4 % annualisés par titre (× √252). Les titres très volatils reçoivent des mises plus petites en dollars, les titres peu volatils des mises plus grandes.
Avantages
- Égalise la contribution ex ante au risque entre les titres. Le drawdown n’est plus dominé par les positions qui se trouvent être les plus volatiles du moment.
- Aucune estimation d’avantage par signal. La règle suppose implicitement un Sharpe égal entre les titres, une hypothèse d’avantage uniforme, mais pas signal par signal.
- Se met à jour seule à partir des données de marché : les barres d’hier alimentent l’estimation de volatilité d’aujourd’hui. Aucune table de correspondance
(p, b)à rafraîchir.
Inconvénients et pièges
- Réduction procyclique du risque sur les creux en V. La volatilité augmente pendant une correction → l’entrée suivante est sous-dimensionnée → la reprise se fait avec une petite taille → la volatilité se normalise juste à temps pour la correction suivante. C’est un vrai problème dans les portefeuilles actions. Parades habituelles : fenêtre d’estimation plus longue, EWMA avec un plancher,
target_fractionplafonné. - L’estimateur de σ est un hyperparamètre caché. Écart type simple, EWMA (RiskMetrics), GARCH, plage de Yang-Zhang, volatilité réalisée intrajournalière. Chacun donne un dimensionnement différent. L’écart type EWMA sur 50 jours utilisé dans le moteur KreamEdge est un choix par défaut défendable pour des stratégies quotidiennes, retenu pour sa simplicité opérationnelle et la stabilité de l’estimateur plutôt que pour sa réactivité, mais il est en retard au début des chocs. Yang-Zhang ou GARCH réagissent plus vite, au prix de plus de bruit dans la taille.
- Le ciblage de volatilité par titre n’est pas un ciblage de volatilité au niveau du portefeuille. Dix titres corrélés dimensionnés à 4 %/an chacun ne donnent pas un portefeuille à 12,6 % (√10 × 4 %). La corrélation croisée lors d’une compression sectorielle peut porter ce chiffre à plus de 25 %. Le banc de l’article et le dimensionnement réel de KreamEdge fonctionnent par titre ; l’écart avec un véritable ciblage de volatilité de portefeuille tenant compte des corrélations est réel et n’est pas comblé ici.
- Plus de rotation. Les estimations de volatilité dérivent → les tailles cibles dérivent → des trades de rééquilibrage. Les données du banc ci-dessous le quantifient.
- Hypothèse d’avantage égal. Si vos signaux de plus forte conviction ont aussi tendance à se déclencher sur les titres les plus volatils, le dimensionnement sigma jette de l’information de signal.
Le ciblage sigma est la couche de base de la plupart des portefeuilles systématiques institutionnels. La couche suivante est la parité de risque / contribution égale au risque au niveau du portefeuille (tenant compte des corrélations), et la couche au-dessus est une cible stricte de volatilité du portefeuille combinée à un effet de levier conditionné au régime. Cet article reste à la couche de base, car c’est ce que KreamEdge implémente réellement.
4. Profil opérationnel : qui paie la facture de maintenance ?
La comparaison théorique ne couvre que la moitié du tableau. L’autre moitié est le coût opérationnel sur la durée de vie du système, et c’est là que Kelly est le plus faible.
Les deux handicaps opérationnels de Kelly
(a) Les données d’entrée ne sont pas observables sur le marché. p (taux de réussite) et b (R/R) viennent de vos exécutions historiques et d’un moteur de backtest. Cela signifie :
- Fréquence de rafraîchissement. Pour rester calibrés,
(p, b)doivent être réestimés périodiquement. Une fois par mois est plausible ; une fois par semaine est plus défendable. Chaque rafraîchissement est un pipeline non trivial (mise à jour complète des OHLCV, recalcul des signaux, exécutions simulées, agrégation des statistiques). - La maintenance par stratégie croît linéairement. Le banc de KreamEdge compte plus de 100 stratégies. Cela fait plus de 100 paires
(p, b)à garder à jour, chacune avec son choix de fenêtre de backtest, sa période de chauffe et son hypothèse de slippage. - La dérive de régime rend les
(p, b)agrégés trompeurs. Un backtest sur 18 mois de marché haussier produitp ≈ 60 %,b ≈ 2.5, et Kelly dit d’augmenter la taille. Les 6 premières semaines d’une correction détruisent cette estimation, mais Kelly ne réduit la taille qu’une fois que le nouveau run reflète la perte, et à ce moment le mal est fait. Le même retard joue contre vous lors de la remontée.
Une précision mérite d’être explicitée : rafraîchir un estimateur n’est pas la même chose que réajuster des paramètres. Si vous recalculez seulement (p, b) sur de nouvelles données sans changer les paramètres de la stratégie, vous mettez à jour une statistique. Ce n’est pas du data snooping. Le snooping apparaît quand vous re-réglez les paramètres de la stratégie sur les nouvelles données puis calculez (p, b) à partir de la stratégie re-réglée. En pratique, presque tous ceux qui relancent Kelly relancent aussi l’optimiseur, donc le cas du snooping est le plus courant, mais ce sont des opérations distinctes.
Il existe une alternative plus propre : estimer (p, b) à partir des exécutions réelles glissantes, et non de nouveaux runs du backtest. C’est réellement hors échantillon. Sa faiblesse est la puissance statistique : une stratégie qui se déclenche 30 fois par an ne peut pas garder (p, b) calibrés assez vite pour réagir à un changement de régime. Pour des portefeuilles institutionnels, cela convient ; pour une structure systématique d’une seule personne, c’est rédhibitoire pour la plupart des stratégies. Il existe aussi une variante bayésienne/bootstrap : intégrer sur la loi a posteriori de (p, b) et dimensionner sur le quantile inférieur, ce qui est la réponse de principe à l’incertitude sur les données d’entrée, mais qui exige une infrastructure non triviale.
(b) Réel ≠ backtest. Les (p, b) de backtest proviennent d’exécutions idéalisées (prix médian, taille complète, instantanées). Les (p, b) réels incluent le slippage, les exécutions partielles, les ordres manqués et le délai entre signal et exécution. L’écart va toujours dans le sens prudent : l’avantage réel est plus faible. Donc même un Kelly de backtest parfaitement à jour est biaisé vers le surdimensionnement. Notez que le Kelly fractionnaire traite le problème du bruit sur les données d’entrée (MacLean/Thorp/Ziemba) ; il ne traite pas l’écart entre réel et backtest, qui est un problème de biais et non de variance. Ce biais doit être corrigé séparément, en validant périodiquement les hypothèses de slippage sur les données réelles (ce qui fait encore un pipeline de maintenance).
Le bilan de (a) et (b) : faire fonctionner Kelly correctement suppose de mettre en place une infrastructure pour rafraîchir (p, b) par stratégie à un rythme rapide, valider les décotes de slippage sur les exécutions réelles, et soit faire tourner la version sur exécutions réelles (ce que la plupart des structures individuelles ne peuvent pas faire à cause de la taille d’échantillon), soit accepter un certain coût de data snooping dû à des réoptimisations fréquentes. Pour une petite structure systématique, cela dégénère presque toujours en « j’ai fait tourner un backtest en mai et je trade sur ces chiffres depuis », et à ce stade Kelly n’a rien apporté que le dimensionnement fixe n’aurait apporté.
Ciblage sigma : des données d’entrée réelles qui se mettent à jour seules
Sigma utilise la volatilité réalisée de l’actif, calculée à partir des OHLCV. Les propriétés qui comptent sur le plan opérationnel :
- Aucune dépendance au backtest. Les barres d’hier deviennent automatiquement l’estimation de volatilité d’aujourd’hui. La DAL dispose déjà des données.
- Autocorrection lors d’un changement de régime (sous réserve de la mise en garde sur les allers-retours procycliques du §3). Une hausse de la volatilité réduit l’entrée suivante ; aucun nouveau run nécessaire.
- Par titre, pas par stratégie. L’estimateur est une propriété de l’instrument, pas du signal. Ajouter une stratégie sur le même univers ne multiplie pas la charge de maintenance.
- Un seul hyperparamètre principal :
sigma_target_pct. Choisissez-le une fois en fonction du budget de volatilité au niveau du portefeuille ; révisez-le chaque année. La fenêtre et la famille de l’estimateur de σ forment un second hyperparamètre, mais on le change rarement une fois choisi.
L’implémentation lit l’estimation de volatilité directement dans le pipeline OHLCV au moment du signal et divise : pas de tâche de rafraîchissement séparée, pas de table de correspondance (p, b), pas de question « quand avons-nous réglé cela pour la dernière fois ».
Mise à jour de novembre 2026 : cela restait vrai pour dimensionner les nouvelles entrées. Appliquer un budget de risque sigma aux positions déjà ouvertes exigeait en revanche un canal de rafraîchissement entre le côté signal et le côté exécution, et c’est l’une des raisons pour lesquelles KreamEdge a basculé sa valeur par défaut vers le dimensionnement fixe en octobre 2026.
Fraction fixe : aucune maintenance
Fixez w. C’est tout. La seule question opérationnelle est de savoir si w reste adapté à la taille actuelle du compte et à l’appétit pour le risque, une révision trimestrielle ou annuelle au plus.
Hiérarchie opérationnelle
| Règle | Données nécessaires | Fréquence de mise à jour | Mode d’échec si les données sont périmées |
|---|---|---|---|
| Fixe | Un seul nombre (w) |
Révision annuelle | Sous-optimal, jamais faux |
| Sigma | Volatilité réalisée par titre (en direct) | Automatique (glissante) | Mauvais si l’estimateur de σ est cassé ; procyclique sur les creux en V |
| Kelly | (p, b) par stratégie, tirés du backtest et d’un modèle de slippage |
Mensuelle ou plus rapide | Surdimensionnement lors des changements de régime ; data snooping si des réajustements accompagnent les rafraîchissements |
Cet écart opérationnel est sans doute la principale raison pour laquelle Kelly déçoit en pratique même là où il dominerait en théorie : la théorie suppose des données d’entrée exactes et à jour ; la réalité opérationnelle est qu’elles sont périmées et biaisées à la hausse. Sigma et le dimensionnement fixe contournent ce problème : sigma parce que ses données d’entrée sont observables sur le marché, le fixe parce qu’il n’a aucune donnée d’entrée à entretenir.
5. Le test A/B : quatre instantanés du moteur sur le banc KreamEdge
KreamEdge fait tourner un banc d’essai de stratégies, un ensemble de stratégies optimisées sur plusieurs zones (Europe, US, Crypto, APAC), tailles de barres et devises de base. Chaque stratégie porte un identifiant stable, ce qui permet de suivre la même configuration d’un instantané du moteur à l’autre.
5.0 Mises en garde : à lire avant les chiffres
Il s’agit d’une série d’instantanés historiques du moteur, pas d’une expérience conçue comme telle. La position éditoriale de référence sur l’hygiène des backtests est exposée dans Pourquoi les backtests de trading par LLM sont (pour la plupart) absurdes (en anglais), et un compte rendu comparable de résultat nul en paires appariées est la récente analyse du filtre de régime de marché SPX (en anglais) ; les mises en garde ci-dessous sont la version de cette hygiène appliquée à ce banc précis. Trois contaminations spécifiques :
- Le modèle de coûts et de financement a évolué pendant la période du banc. Au cours des quatre semaines pendant lesquelles la dernière cohorte était assemblée, le moteur a acquis un modèle de marge de type hedge fund (invariant d’exposition brute et appel de marge), un taux de base d’emprunt de titres actualisé, des plafonds d’écart de marge de courtier grand public re-réglés et une valeur par défaut différente pour la comptabilisation des frais d’emprunt. Le score composite a aussi été re-réglé. Tout Δ en paires appariées entre instantanés absorbe des changements qui n’ont rien à voir avec le dimensionnement. Les premiers deltas A→B et A→C, en particulier, incluent cette dérive, et pas seulement le changement d’indicateur sigma.
- La sélection des lignes utilise le score composite. Si la formule du score composite a changé entre instantanés (ce qui a été le cas au moins une fois), le « meilleur composite » retient des lignes différentes de chaque côté. Une inspection manuelle a confirmé que les mêmes identifiants stables ont survécu, mais la configuration gagnante pour un même titre peut différer d’un instantané à l’autre pour des raisons sans rapport avec le dimensionnement.
- Aucune correction pour comparaisons multiples. Cinq métriques × quatre contrastes = vingt tests d’hypothèse ; aucun des intervalles de confiance bootstrap ci-dessous n’est corrigé pour la multiplicité. Lisez les résultats principaux comme des tendances sur l’ensemble des métriques, pas comme des affirmations de significativité isolées.
Le banc donne donc des indications sur le sens et l’ordre de grandeur des effets, pas une mesure précise et testée unitairement de sigma contre la fraction fixe. Traitez les chiffres comme des éléments dans une chaîne d’arguments, pas comme des estimations causales.
5.1 Les quatre instantanés
| Instantané | Règle de dimensionnement | Poids du score | Remarques |
|---|---|---|---|
| A | Fraction fixe | Vecteur de score à 16 éléments, optimisé | Référence |
| B | Sigma, budget de volatilité quotidienne de 0,25 % | Identiques à A (seul l’indicateur sigma a été basculé) | Changement du dimensionnement seul |
| C | Sigma, budget de 0,25 à 0,40 % | Identiques à A sur les lignes historiques ; 21 nouvelles lignes optimisées à neuf | La « réopt » était partielle |
| D | Sigma, budget de 0,40 % (pour l’essentiel) | 11 poids (5 élagués) + re-réglage | Re-réglage complet + élagage du score |
Les paires sont appariées par identifiant stable de stratégie ; on retient de chaque côté la ligne au score composite le plus élevé. Tous les chiffres Δ sont (R − L) par stratégie. Les intervalles de confiance bootstrap sont des intervalles en centiles sur 2 000 échantillons, calculés sur la médiane.
5.2 A → B : sigma activé, poids hérités (n = 133)
Les 133 lignes appariées avaient toutes des poids de score identiques à ceux de A. L’optimiseur n’a pas tourné ; seul l’indicateur de dimensionnement a changé.
| Métrique | Δ médian | IQR | IC bootstrap à 95 % (médiane) |
|---|---|---|---|
| CAGR | −0,79 pt | 4,0 | n/d |
| maxDD | 0,00 | 4,0 | n/d |
| Sharpe | −0,04 | 0,21 | n/d |
| Sortino | −0,07 | 0,32 | n/d |
| R/R | −0,32 | 0,85 | n/d |
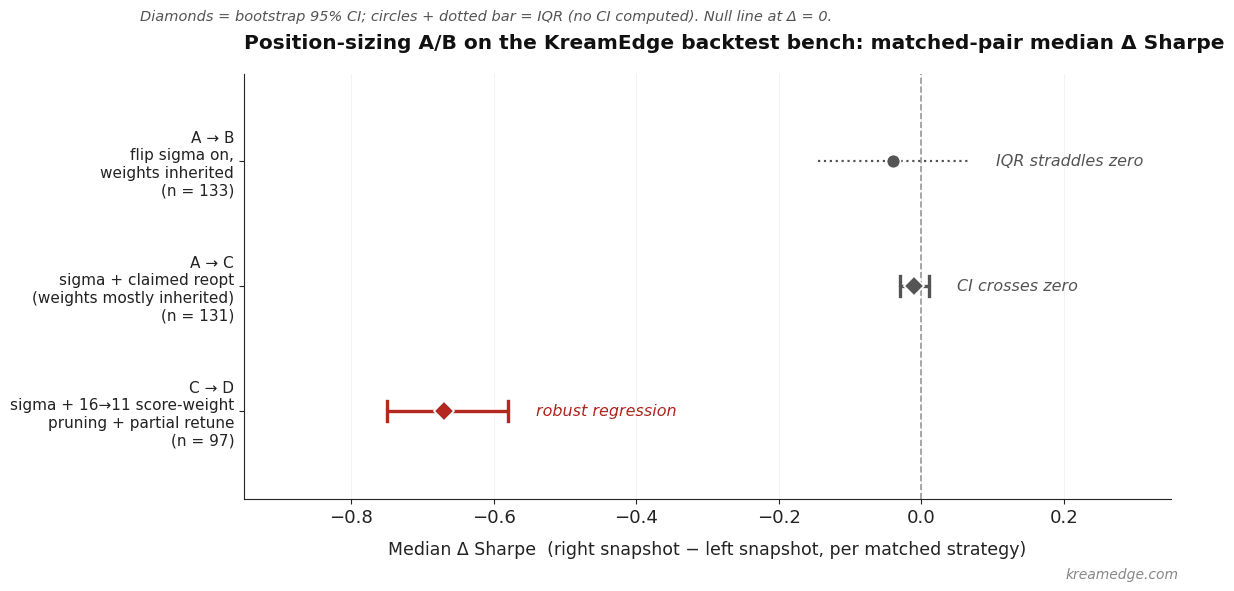
C’est l’isolement le plus propre du « dimensionnement seul » dans le banc, et l’estimation centrale est faible et légèrement négative. L’IQR chevauche zéro sur toutes les métriques ; ce n’est pas un résultat « sigma aide » ou « sigma nuit » à la médiane par stratégie. C’est un pas d’effet évident sur des poids réglés pour la fraction fixe.
5.3 A → C : réopt annoncée (n = 131 appariées + 21 nouvelles)
Le lot C était censé être « sigma + réoptimisé », mais en vérifiant les vecteurs de poids ligne par ligne :
- 130 des 131 titres appariés avaient encore des poids inchangés. L’optimiseur n’a en fait pas retourné sur ceux-là.
- Une seule ligne appariée avait des poids réellement re-réglés.
Les deltas en paires appariées sont en conséquence faibles :
| Métrique | Δ médian | IQR | IC bootstrap à 95 % (médiane) |
|---|---|---|---|
| CAGR | −0,30 | 4,24 | [−0,71 ; −0,01] |
| maxDD | −0,17 | 3,96 | n/d |
| Sharpe | −0,01 | 0,19 | [−0,03 ; +0,01] |
L’intervalle de confiance bootstrap sur le ΔSharpe médian franchit zéro ; celui sur le ΔCAGR médian est étroit mais à peine négatif ([−0,71 ; −0,01]), donc plat en pratique. Le résultat sur le Sharpe ne se distingue pas statistiquement du bruit ; celui sur le CAGR est au mieux marginal. Une formulation antérieure parlait d’un résultat « essentiellement plat, sigma n’a aucun effet quand les poids sont hérités » ; c’est juste quant au sens, mais cela exagérait la précision.
Les 21 stratégies nouvelles dans C, optimisées à partir de zéro avec un dimensionnement sigma, paraissent bien meilleures que la référence A (CAGR médian de 25,7 contre 17,4 ; Sharpe médian de 1,16 contre 0,67). Deux raisons de traiter cela avec prudence :
- Biais de sélection. Un nouveau run de l’optimiseur produit des survivants retenus comme les meilleurs parmi N. Les 21 sont les meilleures d’une recherche à neuf ; la référence A est une cohorte vieillie. Les comparer revient à opposer « le meilleur d’une recherche à neuf sous sigma » et « la médiane d’une cohorte historique sous fraction fixe ». Cela confond les changements de dimensionnement avec l’ancienneté de la recherche. La comparaison honnête est un nouveau run de l’optimiseur sur le même univers avec un dimensionnement fixe, face à un nouveau run sous sigma. Cette comparaison n’a pas été faite.
- In-sample uniquement. Tous les chiffres portent sur la fenêtre d’optimisation. Un contrôle de dérive sur données mises de côté pour les 21 nouvelles lignes est la prochaine étape.
L’affirmation « les stratégies sigma optimisées à neuf sont nettement meilleures que la cohorte historique à dimensionnement fixe » est donc réelle dans les données, mais pas encore attribuable proprement à sigma. Une lecture plus prudente : l’optimisation à neuf sous sigma produit de bonnes stratégies ; la question de savoir si elles sont meilleures qu’une optimisation à neuf sous fraction fixe reste ouverte.
5.4 C → D : sigma + élagage des poids du score de 16 à 11 + re-réglage (n = 97 appariées)
Les 97 lignes appariées avaient toutes des vecteurs de poids modifiés, donc l’optimiseur a réellement tourné. C’est aussi là que les données du banc sont les plus solides :
| Métrique | Δ médian | IQR | IC bootstrap à 95 % | Stratégies améliorées |
|---|---|---|---|---|
| CAGR | −4,12 | 6,99 | [−5,54 ; −3,20] | 24 / 97 |
| maxDD | +8,35 | 10,91 | n/d | 7 / 97 (soit 93 % en recul) |
| Sharpe | −0,67 | 0,60 | [−0,75 ; −0,58] | 5 / 97 |
| Sortino | −1,02 | 0,67 | n/d | 3 / 97 |
| Taux de réussite | −4,14 | n/d | n/d | n/d |
| Nb de trades | +94 (~2×) | 194 | n/d | n/d |
Cette régression est large et statistiquement robuste : les intervalles de confiance bootstrap sont étroits et loin de zéro ; seules 5 des 97 stratégies appariées se sont améliorées sur le Sharpe. Quoi qu’il ait changé entre C et D, cela a fortement nui à la cohorte de stratégies existante.
Les nouvelles stratégies de D (n = 14), optimisées à partir de zéro avec le moteur à 11 poids, paraissent correctes prises isolément (CAGR médian de 24,8, maxDD de 16,3, Sharpe de 0,74). Le moteur à 11 poids peut donc produire de bonnes stratégies, mais les stratégies historiques, re-réglées uniquement sur les poids et sans nouvelle recherche des combinaisons de signaux, ont nettement régressé.
Cet article ne désignera aucun poids en particulier comme le poids porteur ; le banc ne peut pas prouver lequel des 5 poids élagués comptait. Plusieurs explications concurrentes ne sont pas exclues par les données :
- Un ou plusieurs poids élagués faisaient un vrai travail de contrôle du risque.
- Le re-réglage a modifié les 11 poids restants mais a laissé fixes les paramètres de combinaison de signaux et de niveau de stop. C’est une réopt partielle, pas une nouvelle recherche complète.
- Le modèle de coûts et de financement a changé pendant la même période (modèle de marge, base d’emprunt, coefficient composite, tous listés au §5.0). Une partie de la régression est plausiblement attribuable à des modèles de coûts honnêtes qui font fondre des rendements jusque-là surestimés.
- Le budget de recherche de l’optimiseur peut différer d’un instantané à l’autre.
Une ablation propre consisterait à relancer D en restaurant les 16 poids, pour séparer l’effet de l’élagage de celui du re-réglage du composite et des coûts. Cette ablation n’a pas encore été faite. Le titre défendable est empirique : élagage + re-réglage partiel ont produit une régression générale, et non une affirmation causale sur tel ou tel poids.
5.5 Le rendement ajusté de l’exposition précise le tableau
Si sigma dimensionne les positions plus petites, une comparaison brute des CAGR est trompeuse. En calculant le rendement par unité d’exposition brute moyenne (CAGR / exposition en %) :
| Instantané | CAGR médian / exposition |
|---|---|
| A (fixe) | 34,3 |
| C (sigma, poids ~hérités) | 36,2 |
| D (sigma, re-réglage à 11 poids) | 30,1 |
Selon cette mesure, C est légèrement meilleur que A : sigma obtient le même CAGR par unité d’exposition que la fraction fixe, peut-être un peu mieux, mais avec une exposition absolue plus faible. C’est une lecture plus défendable de l’étape A → C que « sigma est neutre ou légèrement pire » : une fois l’exposition brute prise en compte, sigma égale à peu près la fraction fixe, et le CAGR affiché plus bas tient au fait que le portefeuille tourne avec une taille plus petite.
La régression de D résiste à cette normalisation : D est pire en termes bruts comme en termes ajustés de l’exposition, ce qui renforce la conclusion du §5.4.
5.6 Synthèse des quatre instantanés
| Changement | Résultat empirique | Niveau de confiance |
|---|---|---|
| Sigma activé, poids conservés (A → B) | Médiane légèrement négative, IQR à cheval sur 0 | Indiscernable du bruit |
| Sigma + réopt annoncée qui reposait en fait sur des poids hérités (A → C) | Δ médian du CAGR dans [−0,71 ; −0,01] ; Δ du Sharpe dans [−0,03 ; +0,01] | Au mieux marginal ; égale la fraction fixe en rendement ajusté de l’exposition |
| Sigma + stratégies optimisées à neuf (21 nouvelles dans C) | Nettement meilleures que la référence (CAGR +8, Sharpe +0,5) | Réel mais confondu avec un biais de sélection (avantage de la recherche à neuf) |
| Élagage du score de 16 à 11 + re-réglage partiel (C → D) | CAGR −4, Sharpe −0,7, DD +8 | Robuste ; IC étroits |
Le résultat défendable le plus solide est le dernier : les changements structurels du moteur (ici, l’élagage du vecteur de score) exigent une nouvelle recherche complète des paramètres de stratégie, pas seulement un re-réglage des poids. C’est une leçon d’ingénierie, pas une leçon de dimensionnement.
Sur le dimensionnement lui-même, le banc soutient une affirmation plus faible que ne le suggérait la toute première lecture : le dimensionnement sigma est à peu près équivalent en exposition au dimensionnement fixe quand les poids sont réglés pour la fraction fixe, et peut-être meilleur quand on le laisse co-optimiser, mais ce cas « peut-être meilleur » est contaminé par le biais de sélection. Un A/B propre et direct avec optimisation à neuf est nécessaire pour trancher.
6. Enseignements pratiques
Pour une stratégie unique, bien caractérisée, avec un avantage stable et partant de zéro : la fraction fixe est la référence honnête. Elle résiste à l’erreur d’estimation, et la fraction peut être choisie au jugé ou par une intuition de demi-Kelly. Le résultat A → C en paires appariées du banc KreamEdge (Δ du Sharpe indiscernable de zéro, rendement ajusté de l’exposition légèrement en hausse) va dans ce sens : au niveau d’une stratégie isolée, le choix entre fraction fixe et sigma revient au même, donc la règle la plus simple l’emporte.
Pour un panier de stratégies sur un panier de titres aux profils de volatilité très différents (titres individuels + ETF + crypto dans le même portefeuille), le ciblage sigma est la bonne couche de base pour des raisons théoriques (il égalise la contribution ex ante au risque entre des titres hétérogènes), et une cible de volatilité au niveau du portefeuille doit s’y ajouter, car le ciblage de volatilité par titre ignore la corrélation croisée et sous-estimera le budget d’exposition brute lors des compressions sectorielles. Le banc du §5 n’isole pas ce bénéfice de façon empirique, puisque ses stratégies sont mono-instrument ; la recommandation pour les paniers repose sur la théorie, pas sur le banc. Le moteur KreamEdge ne fait pas encore tourner la couche tenant compte des corrélations ; c’est un chantier ouvert.
Quiconque se tourne vers Kelly devrait répondre à deux questions avant de commencer. D’abord : quelle estimation conditionnelle de l’avantage par signal sert de donnée d’entrée ? Si la réponse est « le taux de réussite agrégé du backtest », c’est un dimensionnement fixe sous une justification de Kelly, pas du Kelly. Ensuite : comment (p, b) reste-t-il calibré ? En relançant le backtest (avec le coût de data snooping qu’introduit le re-réglage de la stratégie) ou en l’estimant à partir des exécutions réelles glissantes (ce qui exige assez d’exécutions par stratégie et par période pour être statistiquement significatif) ? Sans pipeline concret pour répondre à la seconde question, Kelly sera périmé en un trimestre et fera des dégâts au prochain changement de régime.
Et quand le vecteur de score ou toute autre pièce structurelle du moteur change, relancez l’optimisation complète, y compris la recherche des combinaisons de signaux, et pas seulement le re-réglage des poids. L’instantané D a élagué 5 des 16 poids du score, re-réglé les poids restants, et produit une régression pure et simple sur 93 % des stratégies historiques. Le moteur à 11 poids n’est pas cassé (les stratégies créées à partir de zéro avec lui paraissent correctes), mais sa surface de perte diffère assez de celle à 16 poids pour que les stratégies historiques ne puissent pas se rétablir par une simple repondération. Les combinaisons de signaux et les niveaux de stop doivent bouger eux aussi, et ce n’est pas ce qu’a fait le re-réglage.
La position la moins défendable consiste à croire qu’une règle de dimensionnement, une formule de score ou un modèle de coûts peuvent être modifiés indépendamment les uns des autres. Ils sont couplés par une même surface de perte. Le banc KreamEdge le montre empiriquement.
KreamEdge s’est appliqué le premier enseignement. Depuis le 12 octobre 2026, le moteur utilise par défaut un dimensionnement à fraction fixe, et le ciblage sigma attend trois choses : une seule unité de volatilité quelle que soit l’unité de temps, une base de volatilité dédiée pour tout budget de risque sur les positions ouvertes, et un A/B propre avec optimisation à neuf.
Questions fréquentes (FAQ)
Quelles règles de dimensionnement des positions cette étude compare-t-elle ?
Trois. La fraction fixe attribue une fraction fixe du capital à chaque entrée. Kelly maximise le taux de croissance géométrique à long terme, conditionnellement à l’avantage et à la variance par pari. Le ciblage sigma, ou inverse de la volatilité, dimensionne chaque position pour que sa contribution ex ante à la volatilité soit égale.
Le ciblage sigma est-il meilleur que Kelly ?
Pas en un sens bien défini. Ils répondent à des questions différentes : Kelly vise la croissance, sigma vise une contribution au risque égale par titre. La thèse de l’article est plus étroite : dans des conditions opérationnelles réalistes, les données d’entrée dont Kelly a besoin ne sont pas disponibles à un coût assez faible pour compter.
Qu’a réellement montré l’A/B ?
Un A/B sur plusieurs versions, à travers quatre instantanés du moteur, a isolé trois changements : l’activation de sigma sans aucun autre changement, sigma plus une réoptimisation annoncée, et sigma plus réoptimisation plus élagage du vecteur de poids du score. Seul le troisième a produit un résultat net. Les deux premiers sont plus faibles qu’une première lecture ne le laissait penser, et l’article le dit explicitement.
Pourquoi le dimensionnement des positions compte-t-il plus que le choix du signal ?
Parce que le dimensionnement fixe le taux de croissance géométrique du compte, le profil de drawdown et la variance des rendements. Ces éléments dépendent bien plus du capital engagé à chaque entrée que de l’indicateur qui se déclenche.
Pourquoi publier ceci comme un résultat nul ?
Parce que le banc n’a pas pu départager proprement le dimensionnement fixe et le dimensionnement sigma. Présenter cette séparation comme réelle aurait exagéré ce que l’expérience permet d’affirmer.
Quel dimensionnement des positions KreamEdge utilise-t-il aujourd’hui ?
Le dimensionnement à fraction fixe, utilisé par défaut depuis le 12 octobre 2026 dans les backtests KreamEdge comme dans le pipeline de signaux. Le ciblage sigma reste disponible mais désactivé, car un poids fixe garde la stratégie indépendante de l’exécution et signifie la même chose sur toutes les unités de temps. KreamEdge prévoit de revenir au ciblage sigma pour les portefeuilles qui mélangent des volatilités très différentes, dès que l’unité de volatilité et un A/B propre le justifieront.
Nous ne le traderions pas tel quel : c’est de la recherche uniquement. Il s’agit de recherche sur backtest historique publiée à des fins informatives et pédagogiques, pas d’un conseil en investissement ; les performances passées ne préjugent pas des résultats futurs.
Recherches KreamEdge associées
- La gestion du risque après la débâcle de l’IA : volatilité et biais (en anglais)
- Filtre de régime de marché : un résultat nul (en anglais)
- Portefeuille 1D combiné actions américaines et indices mondiaux (Backtest 332) (en anglais)
- Pourquoi la plupart des backtests de trading sont trompeurs (méthodologie) (en anglais)
- Pourquoi le screener et la stratégie doivent partager une seule boucle d’optimisation (en anglais)
- Déflateur de liquidité SPX : un biais silencieux dans les backtests longs (en anglais)
0 commentaire